
AI-agents moeten zelfstandig door programma’s en websites klikken, bestanden bewerken en afspraken regelen. Dat brengt niet alleen beveiligingsrisico’s met zich mee, maar roept ook de principiële vraag op hoe autonoom AI mag handelen. Onderzoekers werken aan controlepunten en persoonlijke dataruimtes, zodat jij de baas blijft.
Computer use agents: veelbelovend, maar nog beperkt
Computer use agents zien wat er op het scherm staat, sturen de muisaanwijzer en typen tekst. Daarmee moeten ze alles kunnen wat een mens ook met een computer kan. Die mens drinkt ondertussen rustig een kop koffie, terwijl de artificiële intelligentie de belastingaangifte invult, mappen doorzoekt of de zakenreis van morgen regelt. Dat is althans het idee, maar zover is het nog niet.
Een aantal grote techbedrijven werkt aan zulke agents. Die zijn tot nu toe echter alleen beschikbaar met een sterk beperkt aantal functies, of als prototype dat alleen onder strenge veiligheidsmaatregelen gebruikt zou moeten worden. ChatGPT Agent hoort bij de eerste categorie. Deze web-agent heeft toegang tot een aantal geselecteerde apps, zoals e-maildiensten of een onlineagenda. Zo kan hij namens jou over het web navigeren en volgens OpenAI bijvoorbeeld een vakantie plannen en boeken. Daarvoor gebruikt hij een eigen browser, waarmee hij door websites klikt.
Reddit-gebruikers zijn lyrisch: de agent zou hebben geholpen om nieuwsbrieven op te zeggen, bij het zoeken naar een restaurant rekening hebben gehouden met persoonlijke voorkeuren of zelfstandig advertenties op eBay hebben opgesteld. Toegang tot de computer van een gebruiker heeft hij weliswaar niet, maar bij het gebruik van apps maant OpenAI zijn klanten wel tot voorzichtigheid, om onbevoegde toegang tot vertrouwelijke informatie te voorkomen.
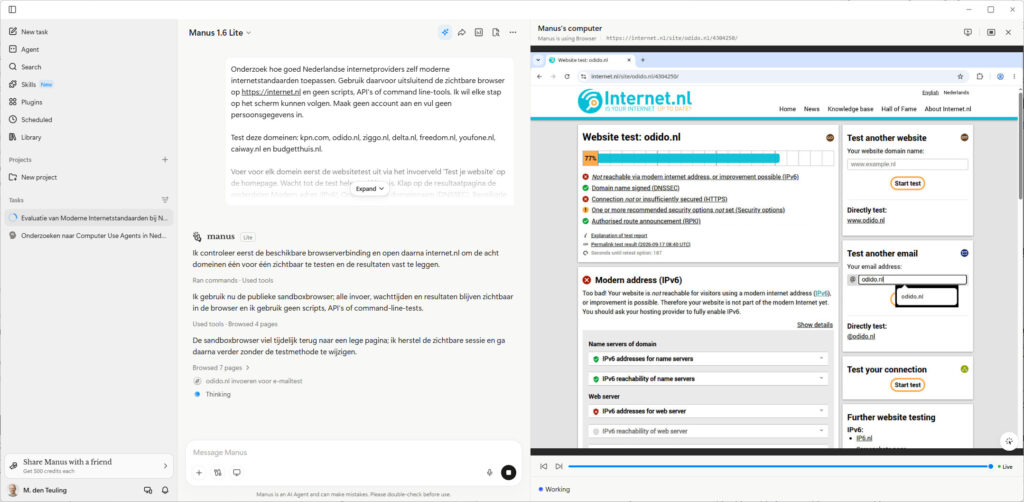
De agent Manus van het in Singapore gevestigde bedrijf Butterfly Effect laat meest openlijk zien hoe een computer use agent (CUA) werkt. Hij gebruikt zijn eigen browser en laat de gebruiker meekijken terwijl hij namens hem door het web klikt – een schouwspel dat soms zelfverzekerd, maar vaak eerder hulpeloos overkomt.
Een wat ongebruikelijke menustructuur op een website kan de agent namelijk al in de problemen brengen. Wie daar het geduld niet voor heeft, kan bij Manus op elk moment de controle overnemen en zelf klikken – dat gaat sowieso sneller.
Digitale stuntelaars
Voordat de digitale assistenten zich op kantoor echt nuttig kunnen maken, moeten er nog heel wat problemen worden opgelost – van gebrekkige trainingsdata en ontbrekende gestructureerde kennis tot de vraag hoe gebruikers de controle over hun digitale medewerker houden.
“Het enige wat we op dit moment op de markt zien, zijn agents die tot op zekere hoogte websites kunnen bedienen”, vat Thilo Stadelmann de stand van zaken samen. De professor artificiële intelligentie en machine learning aan de Zurich University of Applied Sciences (ZHAW) heeft samen met collega’s een overzichtsstudie gepubliceerd. Daarin zijn 87 onderzoeksbenaderingen voor CUA’s onder de loep genomen [1], om de trends in de ontwikkeling te analyseren.
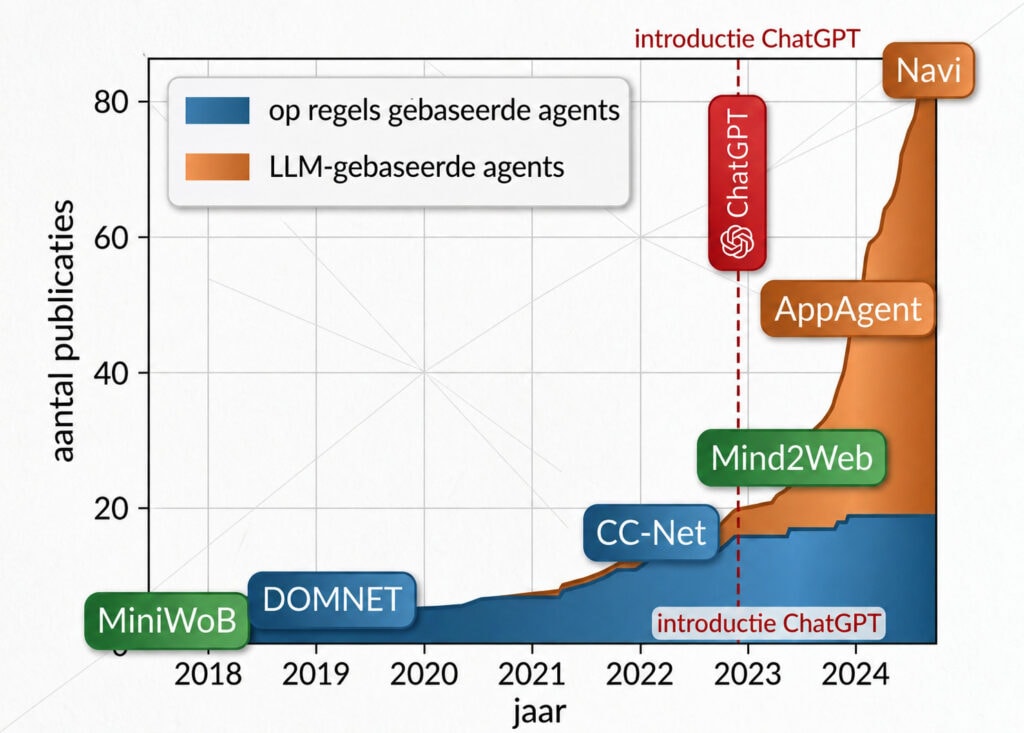
In hun studie richten Stadelmann en zijn collega’s zich vooral op computer use agents die niet tot het web beperkt zijn, maar de hele computer van hun gebruiker besturen. Deze agents werken op het niveau van het besturingssysteem en communiceren met alle denkbare toepassingen, van Office-programma’s en bestandsbeheerders tot systeeminstellingen.
Dat dit terrein met bijzondere uitdagingen gepaard gaat en nog in de kinderschoenen staat, blijkt bijvoorbeeld bij Anthropic. Het bedrijf noemt zijn Computer Use Tool een bètafunctie met unieke risico’s.
Om die risico’s te beperken, raadt Anthropic aan de tool alleen te gebruiken in virtuele machines of containers met minimale rechten en hem in geen geval toegang te geven tot gevoelige gegevens.
Volledige systeemcontrole zet immers de deur open voor potentieel ernstige misstappen: een agent die autonoom op de computer van een gebruiker opereert, zou bijvoorbeeld gevoelige documenten kunnen openen en naar derden kunnen versturen – zonder dat jij daar ook maar iets van merkt.
Zo werkt de agent
Op de achtergrond van zo’n agent draait een vision-language model (VLM) dat een screenshot van het scherm verwerkt. Daaruit genereert het een tekstuele beschrijving van wat er moet gebeuren, plus een script dat dat voornemen omzet in muis- en toetsenbordacties.
De aanwijzer beweegt de assistent via een raster of via coördinaten op het scherm. Zodra de actie is uitgevoerd, maakt het model de volgende screenshot en begint het opnieuw, tot de taak klaar is.
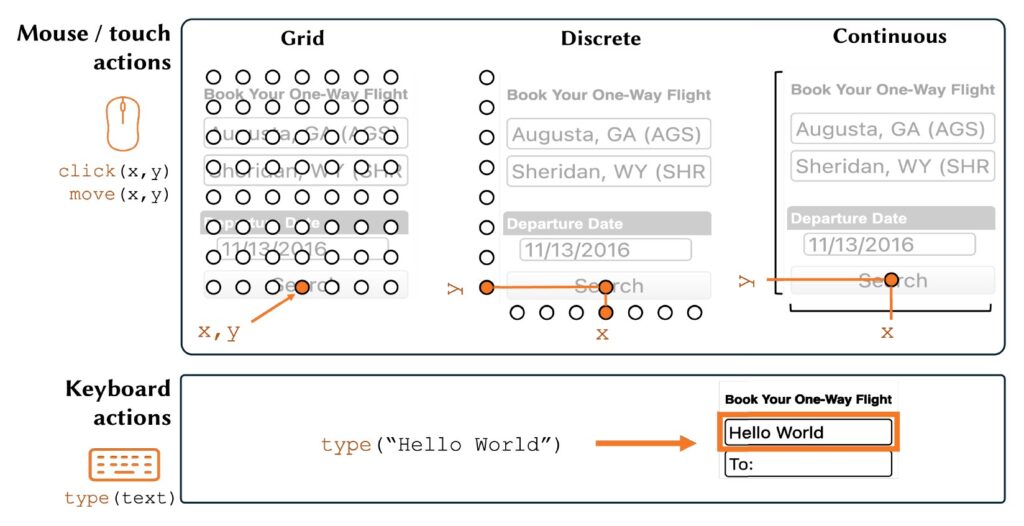
Maar waarom werkt men ook bij pure web-agents met screenshots van websites, in plaats van de agent rechtstreeks de HTML-code te laten lezen? “De code van websites is vaak rommelig, onoverzichtelijk of bevat dingen die helemaal niet bedoeld zijn om je mee bezig te houden”, legt Stadelmann uit. “Bovendien wil je zo dicht mogelijk zitten bij wat een mens ook zou zien, omdat je immers ook menselijke handelingen wilt simuleren.”
Aan het exorbitante energieverbruik van de VLM’s besteedt men volgens hem weinig aandacht. Gebruikers klagen wel over hoe traag zulke web-agents werken. Anthropic heeft dat probleem voor zijn Computer Use Tool zelf erkend.
Knelpunt trainingsdata
Voor het trainen van CUA’s ontbreken niet alleen datasets die laten zien hoe ze van screenshots en talige instructies tot muis- en toetsenbordinvoer komen. “Handelingen leren als ‘ik klik daar, het venster gaat dicht’ is nog relatief eenvoudig”, zegt Stadelmann. “De moeilijkheid zit erin om van een abstracte opdracht te komen tot een hele keten van acties, zoals scrollen, klikken of invoeren, die moet worden afgewerkt om het doel te bereiken.”
De beste uitgangspositie om dit knelpunt in de ontwikkeling te overwinnen hebben grote bedrijven als Amazon, eBay of Meta. Zij hoeven daarvoor alleen maar te observeren hoe hun klanten hun websites gebruiken. Data waaruit een agent kan leren menselijk gedrag na te bootsen, zijn echter pas het begin.
Net als autonome robots moeten ook CUA’s eigen ervaringen opdoen in hun wereld. Hun voordeel ten opzichte van robots is dat ze zich vanaf het begin in een digitale wereld bewegen. Met de methode ‘klik overal op en kijk wat er gebeurt’ kunnen ze zich uitleven en leren.
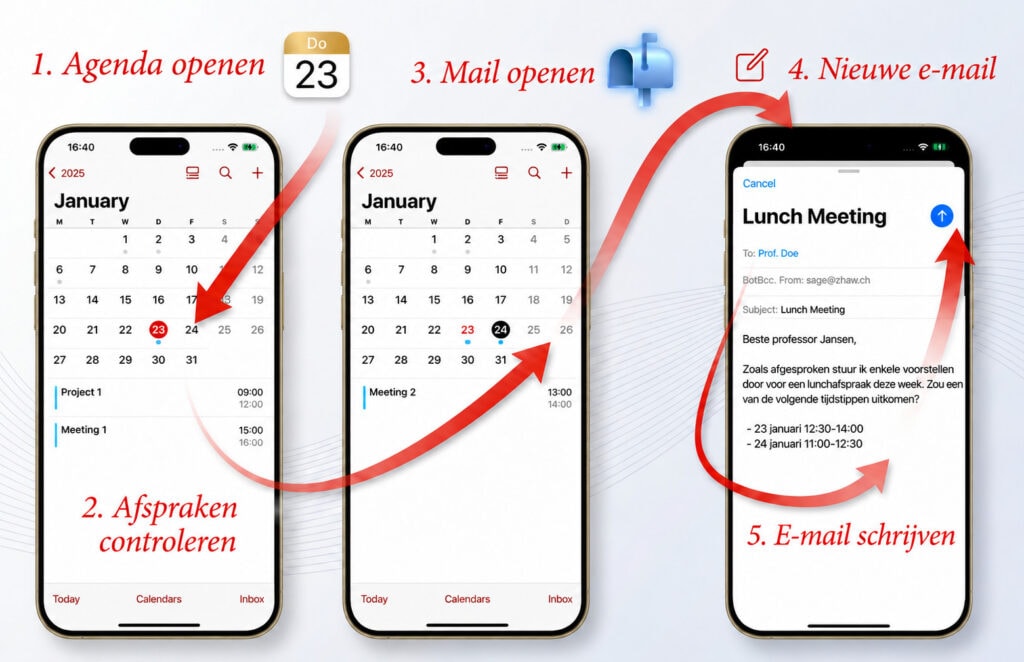
Al een eenvoudige opdracht als Ik wil met professor Jansen gaan lunchen. Zoek naar mogelijke momenten deze week en stel hem per e-mail geschikte tijdsloten voor vraagt van een agent dat hij meerdere onafhankelijke stappen in de juiste volgorde zet om zijn doel te bereiken.
Taken waarbij gegevens moeten worden opgevraagd en verwerkt, kunnen al snel honderden stappen vergen. Bij elke afzonderlijke actie moet de agent kiezen tussen meerdere opties. Net als bij schaken wordt de boom van mogelijke stappen zo heel snel heel breed. “De beslissende vraag daarbij is met welke strategie de AI die boom doorzoekt om haar doel te bereiken”, zegt Stadelmann.
Voor spelwerelden als schaken en go is dit probleem al opgelost: na talloze partijen tegen zichzelf leert de AI inschatten welke zetten kansrijk zijn, en perkt zo de enorme zoekruimte in. Voor computer use agents geldt dat niet. “Zodra een grote speler zich dat serieus voorneemt, zou het echter binnen vijf jaar haalbaar moeten zijn om een CUA te ontwikkelen die – te beginnen bij eenvoudige taken – net als een mens kan leren een computer te bedienen”, meent Stadelmann.
Controle is beter
Een ander probleem is de gebrekkige betrouwbaarheid van taalmodellen, gecombineerd met een gebrek aan controle door de gebruiker. Als AI-agents complexe problemen moeten oplossen, grijpen ontwikkelaars namelijk doorgaans naar prompt chaining. Daarbij formuleert het AI-model een reeks opeenvolgende prompts en werkt het de taak zo stap voor stap af. Zo kan het zich in elke stap concentreren op één duidelijk afgebakend aspect. Op Vat deze rapporten samen volgt Haal uit de samenvatting de belangrijkste risico’s en daarna Stel op basis van de risico’s een actieplan voor.
Het hele proces ligt daarbij in handen van het probabilistisch werkende taalmodel. Omdat er geen overkoepelend, logisch kader is, wordt de AI-agent in feite bij elke aanroep opnieuw gegenereerd. Hij levert dan ook elke keer andere resultaten. Die onbetrouwbaarheid van prompt chaining wordt problematisch als een CUA kritieke taken moet uitvoeren waarbij hij ook schade kan aanrichten, bijvoorbeeld door namens zijn gebruiker bindende bestellingen te plaatsen.
Naast die onbetrouwbaarheid is het gebrek aan menselijke controle een tweede probleem: “Als in een computer use agent intern voortdurend alleen taalmodellen berichten uitwisselen, ontbreekt een concreet gedefinieerd punt waarop een mens zou kunnen ingrijpen voordat een kritieke beslissing wordt uitgevoerd”, merkt Uwe Borghoff op.
De hoogleraar softwaretechnologie aan de University of the Bundeswehr Munich heeft daarom een architectuur voor agents ontwikkeld die een vaste wiskundige structuur voorschrijft [2]. Die garandeert gedefinieerde controleposten op beslissende punten – en wel los van de nauwelijks navolgbare beslissingen van een LLM.
Borghoff vergelijkt zijn architectuur met een noodstopknop: een betrouwbare manier om de agent een halt toe te roepen. “We kunnen de mens niet voortdurend erbij betrekken, en we willen het geheel natuurlijk ook niet volledig autonoom maken”, legt Borghoff uit. “Daarom is het beter als een digitale logica precies gedefinieerde punten vastlegt waarop de mens kan ingrijpen.”
Controle voor hoogrisicosystemen
Ook ChatGPT-agent vraagt volgens OpenAI om toestemming voordat hij belangrijke acties uitvoert, zoals het versturen van een e-mail. En inderdaad raken gebruikers al geïrriteerd omdat de agent steeds weer handmatig moet worden aangespoord om door te gaan. Bovendien zijn de beveiligingsmaatregelen van grote techbedrijven van nature grotendeels ondoorzichtig.
Daardoor is de werking van hun agents niet onafhankelijk na te gaan en weinig betrouwbaar. Borghoffs architectuur, TB-CSPN genaamd (Topic-Based Communication Space Petri Net), is daarentegen opensource en kan door de onderzoeksgemeenschap worden gevalideerd, wat vertrouwen wekt.
De digitale logica, dus de onwrikbare regels voor de interne processen van een agent en vooral voor de punten waarop kritieke beslissingen vallen, is bij TB-CSPN uitgevoerd als een zogeheten petrinet. Petrinetten, al in de jaren zestig bedacht door de Duitse informaticus Carl Adam Petri, zijn visuele schakelschema’s die complexe processen weergeven waarin meerdere dingen parallel kunnen gebeuren.
Aan de hand van vaste regels leggen ze vast wanneer welke verwerkingsstap wordt uitgevoerd en onder welke voorwaarden de volgende stap mag beginnen.
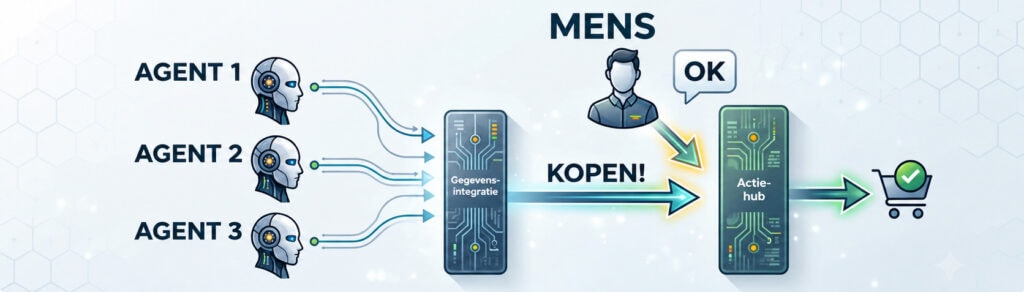
Borghoff en zijn collega’s illustreren hun aanpak aan de hand van een beleggingsdienst. Daarbij analyseert eerst een LLM-agent financieel nieuws en haalt daar markttrends of kwartaalcijfers uit. Volgens de logica van het petrinet activeert die vervolgens AI-agents die historische data evalueren of risico’s analyseren.
Voordat de AI effecten koopt, moet de gebruiker het resultaat goedkeuren. “Niet het LLM neemt de beslissing, maar de mens”, benadrukt Borghoff. “En wel op een precies gedefinieerde plek, direct voordat de agent een kritieke handeling uitvoert.”
Een financiële workflow is voor veel CUA-gebruikers misschien al een uiterst gevoelige zaak. TB-CSPN is echter ook ontworpen voor militaire toepassingen, die onder de strenge wettelijke eisen van de Europese AI Act voor AI-systemen met een hoog risico vallen. Artikel 14 daarvan moet bijvoorbeeld waarborgen dat mensen altijd de controle over AI houden. “Als je agents zonder controle laat werken, belanden we misschien echt ooit in de dystopische wereld van Terminator”, waarschuwt Borghoff. “Daarom is menselijk toezicht voor kritieke AI-systemen onmisbaar.”
Gepersonaliseerde agents
Computer use agents die op LLM’s zijn gebouwd, kampen net als die modellen met hallucinaties. Bij taalmodellen beperkt retrieval-augmented generation dat probleem: de agent zoekt daarbij naar bronnen in lokale documenten of op het web voordat hij een antwoord genereert of een handeling uitvoert, en voegt de gevonden informatie toe aan zijn prompt.
“Het taalmodel haalt de informatie dan uit de prompt en niet uit zijn aangeleerde gewichten, waarin het cruciale feit mogelijk maar gebrekkig is vastgelegd”, legt Andreas Harth uit, hoogleraar bedrijfsinformatica aan de Friedrich-Alexander-Universität Erlangen-Nürnberg. Samen met collega’s heeft Harth op die basis het idee van Computer Use Personal Agents (CUPA’s) ontwikkeld [3]. Een gebruiker kan zo’n agent gecontroleerd toegang geven tot persoonlijke informatie zoals creditcardnummers, adres of voorkeuren.
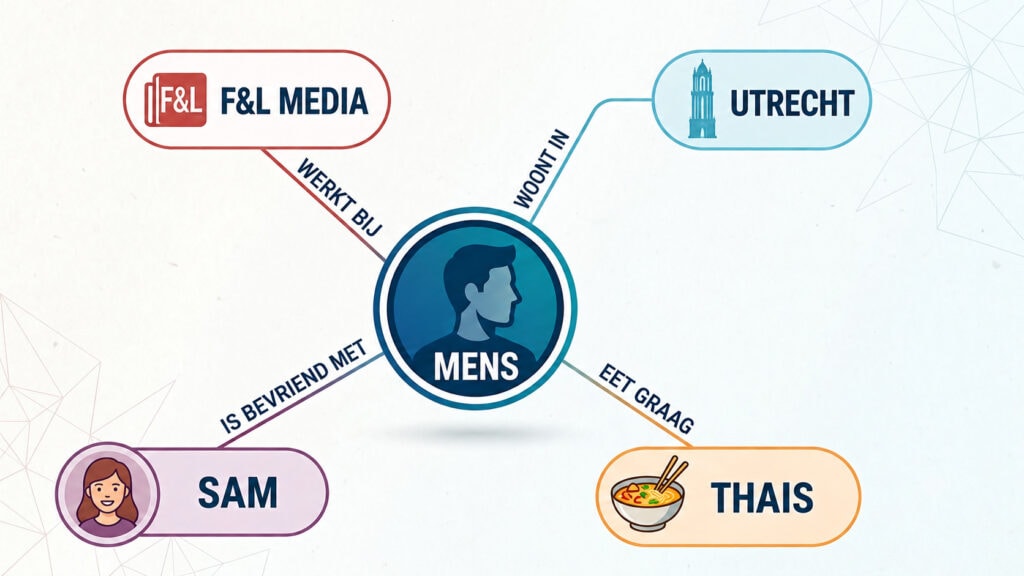
In plaats van alle persoonlijke gegevens die zich in de loop der jaren hebben opgehoopt simpelweg in een prompt te gooien, stellen de onderzoekers voor om knowledge graphs te gebruiken. Die geven data niet weer als losse verzameling, maar als gestructureerd netwerk van knooppunten en verbindingen. In de persoonlijke knowledge graph van bijvoorbeeld gebruiker Sam uit Utrecht zouden de knooppunten ‘Sam’ en ‘Utrecht’ met elkaar verbonden zijn via de verbinding ‘woont in’. “Met knowledge graphs proberen we meer structuur in het systeem te brengen en gestructureerde data door te geven”, zegt Harth. “Dat is in wezen hetzelfde kernidee als bij het Semantic Web.”
Harth illustreert de mogelijkheden van CUPA’s met het voorbeeld van een etentje voor een vriendin. De CUPA combineert persoonlijke gegevens zoals lievelingsgerechten of allergieën uit de knowledge graph met een externe receptendatabase, die eveneens als knowledge graph is georganiseerd, om een voorselectie te maken. Vervolgens neemt hij contact op met de CUPA van de vriendin, die op zijn beurt haar knowledge graph raadpleegt, en controleert hij haar voorkeuren. Samen vinden de agents een geschikt gerecht en een datum. De CUPA bestelt de benodigde ingrediënten en laat ze thuisbezorgen.
Een belangrijke voorwaarde voor de inzet van zulke CUPA’s zou zijn dat de gebruiker bepaalt tot welke gegevens zijn agent toegang heeft. Zo zou de knowledge graph een interface tussen de gebruiker en zijn agent worden, die hij ook van de ene CUA-aanbieder naar de volgende kan meenemen. Harths visie biedt daarmee ook de mogelijkheid om de te verwachten afhankelijkheid van de CUA’s van grote techconcerns te verkleinen.
“In gebruikersenquêtes zegt nu al iedereen dat privacy belangrijk is – om vervolgens toch naar Facebook, Google of Apple te gaan”, relativeert Harth. “Het is dus de vraag of het lukt om uit hun greep te komen.”
De onderzoeker vreest dat CUA’s juist nu, aan het begin van hun ontwikkeling, vooral binnen de gesloten ecosystemen van grote techconcerns hun weg naar de praktijk zullen vinden. Daar kunnen ze immers sneller betrouwbare functies aanbieden. Op de lange termijn zouden die ecosystemen echter ook te beperkend kunnen worden. “In de opensourcewereld kunnen we de interfaces waarmee computer use agents toegang krijgen tot apps daarentegen open en leveranciersonafhankelijk inrichten”, zegt Harth. “Dat geeft me een beetje hoop.”
Thomas Brandstetter en Marco den Teuling
Literatuur
[1] Sager et. al., A Comprehensive Survey of Agents for Computer Use: Foundations, Challenges, and Future Directions, 2026: doi.org/10.1613/jair.1.19490
[2] Borghoff et. al., Beyond Prompt Chaining: The TB-CSPN Architecture for Agentic AI, 2025: mdpi.com/1999-5903/17/8/363
[3] Bonatti et. al., Towards Computer-Using Personal Agents, 2025: arxiv.org/pdf/2503.15515
Praat mee