
Er is veel menselijke intelligentie nodig om te voorkomen dat AI-projecten als een tijger van start gaan en als een (duur) vloerkleed eindigen. Udo Sglavo is bij SAS verantwoordelijk voor toegepaste AI-modellering en onderzoek & ontwikkeling. Hij legt uit waar het op aankomt.
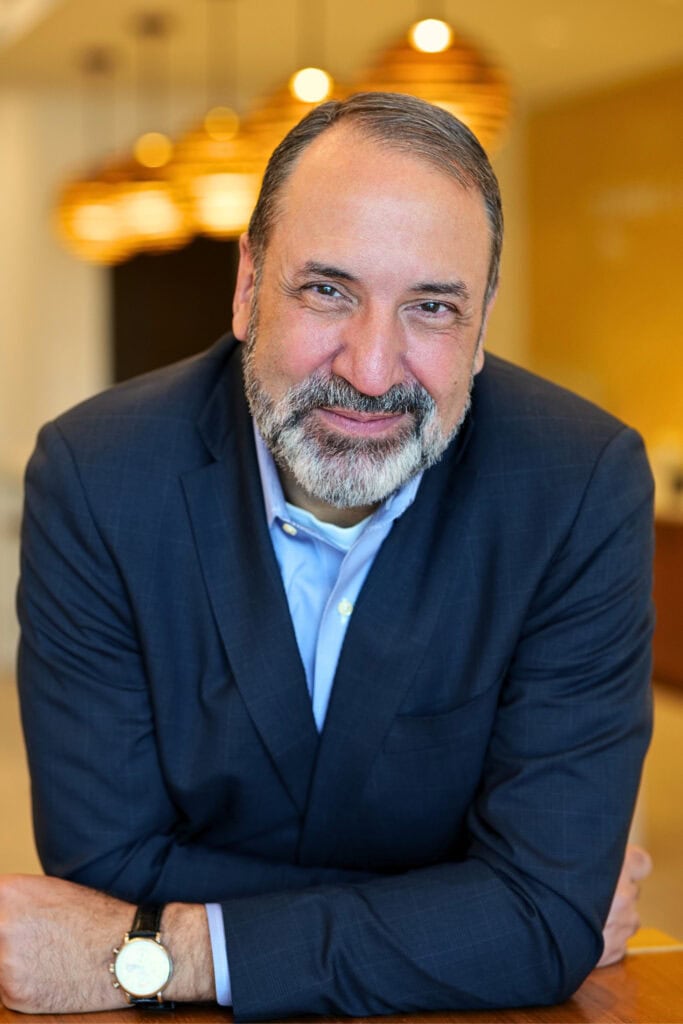
Een camera houdt de productiehal in de gaten en slaat alarm als iemand geen veiligheidshelm draagt. Dat kan ongevallen voorkomen. Maar dezelfde techniek zou ook kunnen vastleggen wie zich wanneer waar bevindt. Of dit arbeidsveiligheid is of een zaak voor de ondernemingsraad vanwege werknemersmonitoring, hangt daarom niet alleen af van het model, maar van de manier waarop het hele systeem is gebouwd.
Met dit soort vragen houdt Udo Sglavo zich bij SAS bezig. De softwarefabrikant behoort al tientallen jaren tot de grote aanbieders van data-analyse en business intelligence en ontwikkelt tegenwoordig ook AI-systemen voor bedrijven. Sglavo is er verantwoordelijk voor toegepaste AI-modellering en onderzoek en ontwikkeling. Daardoor ziet hij niet alleen wat een model in een test kan, maar ook wat er gebeurt wanneer het ingrijpt in echte werkprocessen.
Sglavo legt uit hoe bijvoorbeeld realtime videoanalyse beperkt kan blijven tot de controle op het dragen van een veiligheidshelm of waarom bij een vermoeden van witwassen een bankmedewerker nog moet kunnen beslissen. Veel bedrijven komen echter niet eens zover: ze gaan met de nieuwe technologie aan de slag voordat ze hebben vastgesteld welk probleem ze ermee willen oplossen.
Je hebt veel zicht op de toepassing van AI in de industrie en het bedrijfsleven. Wat zijn de meest voorkomende fouten die bedrijven maken bij de invoering en uitvoering van hun AI-projecten?
De eerste is eigenlijk een klassieke fout die in de technologiesector heel vaak voorkomt: eerst richt men zich op de nieuwe techniek en wordt er gezegd: “O, er is iets nieuws. Hoe kunnen we dat bij ons inzetten?” Die aanpak leidt al snel tot frustratie, omdat het in het bedrijfsleven eigenlijk andersom zou moeten.
Eerst moet je bedenken waar het knelt, welke vragen je wilt aanpakken en misschien al jaren probeert op te lossen zonder ooit tot een bevredigend antwoord te komen. En hoe kan AI helpen die vraag te beantwoorden? Als we ons op bedrijfsspecifieke vragen richten, kunnen we ook vaststellen hoe succesvol we zijn geweest.
Kun je hier een concreet voorbeeld van geven en van het succes?
We hadden een toepassing waarbij we uitgebreid hebben onderzocht of we AI kunnen inzetten om medewerkers in een productieomgeving tegen ongevallen te beschermen. Dan is het doel duidelijk: je wil het aantal ongevallen in de productie omlaag brengen. Dat is geen klassieke AI-vraag, maar een bedrijfsspecifieke vraag.
Vervolgens kijk je hoe je AI daarvoor kunt gebruiken. In dit geval lagen modellen voor de hand die videodata analyseren om medewerkers in de videostream te observeren en vast te stellen: dragen ze een helm, dragen ze handschoenen, gebruiken ze alle voorgeschreven beschermingsmiddelen? Ongevallen ontstaan immers vaak doordat mensen zich niet aan de voorschriften houden.
Het gaat daarbij helemaal niet om afzonderlijke personen, maar om de vraag: is er in deze omgeving iemand die zich op dat moment niet aan de regels houdt? Dan kan het systeem een alarm geven of de leidinggevende rapporten of aanwijzingen sturen, bijvoorbeeld dat het team hierover opnieuw moet worden getraind.
Zoals gezegd draait het er vooral om welk probleem je wilt oplossen en hoe je het succes meet. AI is dan eigenlijk meer een technische bijzaak.
Wat is de tweede fout?
Dat bedrijven eerst prototypes bouwen. Ze proberen dus heel snel allerlei experimenten uit te voeren zonder vooraf duidelijk vast te leggen: hoe gaan we verder als ik succesvol ben? Of wat gebeurt er als ik niet succesvol ben?
Wat ik bedoel is: bedrijven die AI succesvoller invoeren dan andere, zien het niet als een soort speeltuin. Ze bedenken meteen hoe ze het model of project bij succes in het productiesysteem integreren. En juist op dat punt mislukken veel experimenten: er is een model gebouwd en daarbij aannames gedaan over de beschikbaarheid van data of over de mogelijkheid het model in het productiesysteem in te voeren, terwijl die voorwaarden niet zijn gegarandeerd. Dat betekent dat je vanaf het begin ook moet bedenken hoe je zo’n model integreert.
Wat betekent dat voor de praktijk? Hoe ziet dat eruit in het productiesysteem?
In ons geval betekende dit dat er camera’s nodig zijn waarop deze modellen lokaal voor de analyse draaien. Zulke moderne camera’s bestaan inmiddels; ze zijn uitgerust met kleine apparaten die streamingdata direct verwerken.
Daardoor kun je de data in realtime door een model laten beoordelen. Natuurlijk moet je juist bij zulke systemen ook waarborgen dat er geen privacyregels worden geschonden.
Videostreams mogen bijvoorbeeld niet eindeloos worden opgeslagen en er mag geen persoonsherkenning plaatsvinden, want dat zou neerkomen op een soort continue bewaking op de werkplek. Het systeem moet alleen controleren of iemand een helm draagt en dan een alarmsignaal geven.
Met welke data trainen jullie zulke systemen?
We kunnen inmiddels synthetische data genereren die zulke ongevallen simuleren, omdat we een samenwerking met game-ontwikkelaar Epic Games zijn aangegaan. De game-engine van Epic Games kan ook worden gebruikt om zogeheten digitale tweelingen op te bouwen.
Daarmee hebben we als het ware een digitale tweeling van een productieomgeving gemaakt waarin we ongevallen simuleren. Of we simuleren dat mensen zonder helm rondlopen. Het voordeel is dat we deze videodata niet meer handmatig hoeven te labelen.
Dat is bij beeldanalyse namelijk altijd het probleem: je hebt beelden en de computer weet niet wat erop staat. Iemand moet dus aangeven: dit is een mens, dit is een helm.
Bij twee of drie beelden is dat te doen, maar bij een videostream wordt het al een stuk arbeidsintensiever. Doordat we de omgeving nu zelf synthetisch genereren, zijn alle objecten en personen in de video al gelabeld. Die data gebruiken we om onze modellen te trainen. Vervolgens worden die modellen in de camera’s geïntegreerd en draaien ze in realtime.
Je voorbeeld beschrijft een systeem waarmee het relatief makkelijk is succes te behalen, omdat het niet te veel nieuwe problemen oplevert. Als het bijvoorbeeld drie werknemers zonder helm niet herkent, is het nog altijd beter dan helemaal geen systeem.
Het bedrijf heeft dus veel profijt van de gevallen die wel worden herkend en vrijwel geen extra werk door fout-positieven of fout-negatieven. Lastiger wordt het wanneer fouten mogelijk enorm veel werk voor menselijke controleurs veroorzaken. Heb je een voorbeeld van hoe zulke knelpunten in complexere toepassingen te voorkomen zijn?
We zijn groot voorstander van de zogeheten human-in-the-loop-aanpak: de systemen die we bouwen moeten besluitvorming ondersteunen. Op gebieden waar heel veel beslissingen moeten worden genomen, is het belangrijk uit te zoeken waarop je je moet concentreren.
Concreet: bij welke beslissingen moet nog eens een mens meekijken en welke gevallen zijn zo duidelijk dat ik juist niet wil dat een mens ernaar kijkt?
Witwassen is zo’n geval waarin AI inmiddels veel wordt ingezet, omdat het ons helpt de regelgeving te lezen. Hoe kan ik vaststellen of een transactie die op dat moment bij een bank wordt uitgevoerd onder verdenking van witwassen valt?
Omdat taalmodellen inmiddels complete boekenkasten vol met wetboeken kunnen lezen en begrijpen, kunnen ze per geval ook beoordelen welke concrete regels mogelijk worden overtreden. Op dit moment doet een menselijke medewerker dat. Die medewerker moet de geldende regelgeving natuurlijk kennen, maar die verandert voortdurend.
We hebben daarom systemen ontworpen die alle regelgeving lezen en vervolgens tegen de medewerkers zeggen: “Oké, hier is een geval dat er zo en zo uitziet; dit zou dit of dat kunnen betekenen.”
De saaie, overduidelijke gevallen krijgt de medewerker steeds minder te zien; die worden steeds sterker weggefilterd. Alleen de gevallen met concrete aanwijzingen voor een verdachte situatie worden doorgestuurd.
Daarbij geeft het model niet alleen een eenvoudige waarschuwing, maar echte beslissingsondersteuning met een concrete beschrijving van wat er mis kan zijn. Bijvoorbeeld dat de klant tien verschillende telefoonnummers gebruikt. Dat ruikt al behoorlijk verdacht.
Dat betekent dat de AI in dit geval in twee stappen werkt? Eerst draait er patroonherkenning die transacties, gedrag van de betrokken personen of iets vergelijkbaars beoordeelt, waarna het taalmodel de zaak analyseert en handelingsvoorstellen voor de medewerker opstelt?
Precies, dat is het verschil met hoe het eerder ging. Eerder had je alleen systemen die met machine learning transacties in de gaten hielden en aangaven wat afwijkend was. Wat vervolgens moest gebeuren, werd aan de medewerker overgelaten.
Nu komen architecturen zoals RAG (Retrieval Augmented Generation) in beeld: alle regelgeving wordt in een intern systeem opgeslagen, als een kleine bibliotheek met documenten die voortdurend wordt bijgewerkt.
De AI vergelijkt concrete gevallen vervolgens alleen met die bibliotheek en zegt: dit zou dit of dat kunnen zijn. Daarnaast sorteert het systeem de gevallen op urgentie, geeft de menselijke medewerker richtlijnen voor de verdere afhandeling en linkt het de bijbehorende bronnen in de regelgeving. Maar ook hier ligt de beslissing of de zaak wordt onderzocht of niet bij een medewerker.
Het is ook een vaak gebruikte dooddoener dat de mens het laatste woord heeft. Maar het risico bestaat dat de mens helemaal niet het laatste woord kán hebben, omdat hij simpelweg geen tijd heeft om alles te controleren wat op zijn bord terechtkomt. Hoe voorkom je dat de mens uiteindelijk alleen de verantwoordelijkheid draagt voor beslissingen die de machine heeft genomen?
Ja, dat is een heel goed punt. Maar je moet ook naar de uitgangssituatie kijken. Op dit moment werken we samen met een Canadese bank. De reden dat ze naar ons toe kwamen, is simpelweg dat de medewerkers overbelast zijn. Ze zeiden: “We kunnen het stijgende aantal transacties niet meer verwerken. We hebben een tool nodig die ons helpt scherper te filteren wat interessant is en wat niet.”
Daarachter zit natuurlijk de hoop dat de werklast daalt. Dat in plaats van 100 zaken nog maar 30 op het bureau belanden, die bovendien al zijn pre-screened. Bij die 30 is de kans ook groter dat de inspanning niet voor niets is.
Heel wat bedrijven zien de kosten exploderen zodra de prototypefase eindigt of wanneer een AI-toepassing echt gaat schalen. Bij sommige bedrijven nemen de tokenkosten plotseling vormen aan waarop niemand had gerekend. Hoe krijg je dit probleem onder controle?
Als dienstverlener zetten wij in op Small Language Models, de kleine broertjes van een Large Language Model, die commerciële aanbieders vaak ook als open-weightsversie aanbieden. We beperken zo’n model tot een heel specifieke vraag die een agent of toepassing stelt.
Zulke Small Language Models kunnen niet alles. Je kunt niet zeggen: “Oh ja even tussendoor, vertel me even wat voor weer het wordt”, of iets dergelijks. Zo’n model is bijvoorbeeld specifiek getraind voor witwaszaken. Daardoor blijven de tokenkosten relatief overzichtelijk.
Een andere aanpak is ze binnen de firewall te laten draaien. Veel organisaties willen hun data sowieso niet naar een externe server sturen, maar modellen in hun eigen bedrijfsomgeving gebruiken; daar werken deze Small Language Models relatief goed.
Hoe onafhankelijk zijn jullie AI-toepassingen van het concrete taalmodel en hoe makkelijk kun je overstappen?
We trainen de Small Language Models in eerste instantie voor onze aanpak. We gebruiken veel opensource, omdat we ervan uitgaan dat de kosten daarmee lager zijn.
Als een Zwitserse bank bijvoorbeeld zegt dat ze een bepaald model niet gebruikt, moeten we het model opnieuw trainen. Die inspanning is echter te overzien, omdat het geen modellen met miljarden parameters zijn.
Dat betekent dat jullie vervolgens gewoon finetunen met de specifieke data voor witwasdetectie of wat dan ook?
Precies. Tot op zekere hoogte kun je met algemene uitgangspunten werken en het laatste stuk van het model wordt vervolgens met lokale, specifieke data getraind.
Je kunt het vergelijken met een bergtocht in de Alpen: ik zoek de top en het Large Language Model brengt me al relatief dicht bij de top. Maar jij hebt misschien andere ambities dan ik; je wil misschien steilere paden nemen. Dan wordt het taalmodel voor de laatste klim op jouw specifieke omstandigheden getraind.
Dit model heeft geen miljarden, maar miljoenen parameters. Daarvoor heb je geen enorme datacenters nodig; je kunt het daadwerkelijk ook op één GPU trainen.
Wat doen jullie als een AI-project eenvoudigweg niet werkt, dus als het model te veel fouten produceert of de workflow niet op die manier uitvoerbaar blijkt?
Dat is zoals overal in dit werkveld. Bij sommige projecten zie je al heel vroeg dat het niets wordt. Of de vraag was misschien niet scherp genoeg geformuleerd. Dat zijn eerder de projecten waarbij we samen met de klant innovatieonderzoek doen, en dat is per definitie open. Het kan tot succes leiden of niet. We proberen ook nadrukkelijk een agile ‘fail-fast’-aanpak te volgen.
Door Andrea Trinkwalder en Alieke van Sommeren
Praat mee