Voor het effectief werken met grote taalmodellen, heb je aan de hardwarekant een krachtige machine nodig met zeer veel werkgeheugen. Het moet echter niet alleen veel zijn, het moet daarbij ook snel zijn.
Lees verder na de advertentie
Grote taalmodellen stellen hoge eisen aan het GPU-geheugen
Grote taalmodellen (LLM’s) stuwen de ontwikkeling van AI-innovatie voort, maar hun enorme omvang kan de efficiëntie van de inferentie bemoeilijken. Modellen zoals Llama 3 70B en Llama 4 Scout 109B hebben mogelijk meer geheugen nodig dan de GPU biedt, vooral wanneer er grote contextvensters worden gebruikt.
Zo is er voor het laden van de modellen Llama 3 70B en Llama 4 Scout 109B in halve precisie (16-bits floating-point getallen, FP16) respectievelijk ongeveer 140 GB en 218 GB geheugen nodig. Tijdens de inferentie hebben deze modellen doorgaans aanvullende gegevensstructuren nodig, zoals de key-value (KV)-cache, die meegroeit met de contextlengte en de batchgrootte.
Een KV-cache die een contextvenster van 128.000 tokens voor één gebruiker (batchgrootte 1) vertegenwoordigt, verbruikt bij Llama 3 70B ongeveer 40 GB geheugen, en dit schaalt lineair mee met het aantal gebruikers.
In een productieomgeving kan een poging om dergelijke grote modellen volledig in het GPU-geheugen te laden, resulteren in een ‘out-of-memory’ (OOM)-fout.
NVIDIA NVLink C2C
De CPU en GPU in de NVIDIA Grace Blackwell– en NVIDIA Grace Hopper-architecturen zijn verbonden via een NVIDIA NVLink C2C, een geheugencoherente interconnect met een snelheid van 900 GB/s die zeven keer de bandbreedte van PCIe Gen 5 biedt.
De geheugencoherentie van NVLink-C2C creëert één enkele, uniforme geheugenadresruimte die door zowel de CPU als de GPU wordt gedeeld (zie afbeelding hieronder), waardoor ze toegang hebben tot dezelfde gegevens en daarop kunnen werken zonder expliciete gegevensoverdrachten of redundante geheugenkopieën.
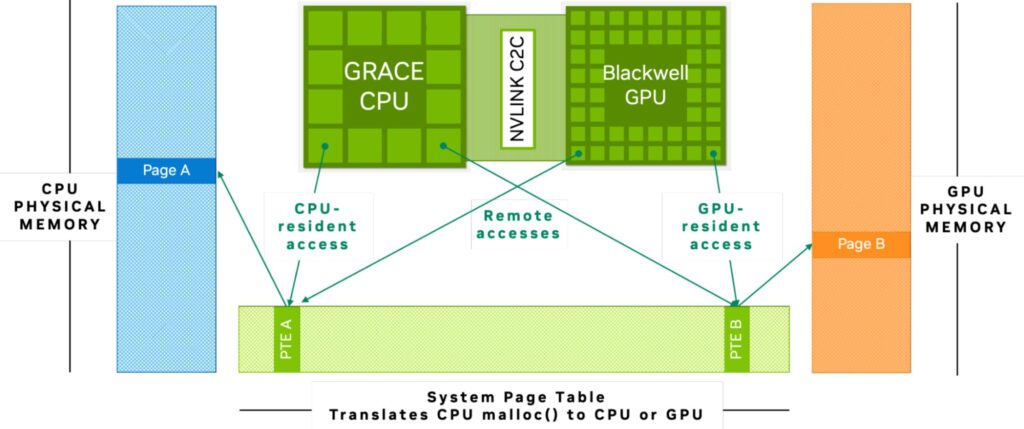
Dankzij deze opzet kunnen grote datasets en modellen gemakkelijker worden benaderd en verwerkt, zelfs wanneer hun omvang de grenzen van traditioneel GPU-geheugen overschrijdt. De verbinding met hoge bandbreedte van de NVLink-C2C en de uniforme geheugenarchitectuur in Grace Hopper en Grace Blackwell verbeteren de efficiëntie van het finetunen van LLM’s, het offloaden van KV-cache, inferentie, wetenschappelijk rekenen en meer, waardoor modellen gegevens snel kunnen verplaatsen en CPU-geheugen kunnen gebruiken als er onvoldoende GPU-geheugen beschikbaar is.
AI naar de edge
Naarmate de AI-revolutie zich blijft verspreiden over talrijke sectoren, sturen de technologieën die erachter schuilgaan de evolutie van het AI-ontwikkelaarslandschap aan. De beschikbaarheid van talloze openbare AI-modellen maakt het voor AI-ontwikkelaars gemakkelijker om prototypes te maken, te experimenteren en AI-aangedreven oplossingen te implementeren.
De vraag naar AI in de edge vereist dat ontwikkelaars kleine taal-AI-modellen maken, grotere modellen kwantiseren en modellen zelfs afstemmen op domeinspecifieke gebruiksscenario’s. De populariteit van multimodale AI-modellen die informatie uit verschillende soorten gegevens, zoals tekst, spraak, afbeeldingen en video’s, kunnen begrijpen en verwerken, groeit snel. Onlangs geïntroduceerde redeneringsmodellen, die interne gedachtegangen kunnen genereren alvorens antwoorden te produceren, vereisen meer rekenkracht.
Agent-gebaseerde oplossingen kunnen complexe taken met meerdere stappen uitvoeren, waarbij vaak gebruik wordt gemaakt van verschillende AI-modellen die gelijktijdig moeten draaien. De rode draad in het landschap van AI-ontwikkelaars is de behoefte aan computeroplossingen die nodig zijn om de diverse reeks workflows aan te sturen in de cloud, op on-premise servers en werkstations, en op lokale machines in de edge.
Ontwikkelaars gebruiken vaak desktop- en laptopcomputers als hun primaire ontwikkelingsplatform en worden aan de hardwarekant geconfronteerd met een tekort aan lokaal GPU-geheugen en de rekenkracht die nodig is voor hun AI-workflow. Daardoor worden ze vaak gedwongen hun werk te verplaatsen naar de cloud of een gedeeld datacenter.
Ontwikkelaars hebben daarom behoefte aan een nieuwe klasse van toegankelijke AI-computers die speciaal zijn ontworpen voor het lokaal bouwen en uitvoeren van AI.
Compacte AI-supercomputer
Om te voldoen aan de eisen van grootschalige AI-modellen en de wens van ontwikkelaars om hun AI-workflow lokaal en consistent te laten verlopen, introduceert GIGABYTE de W775-V10-L01, een AI-supercomputer in een towerbehuizing, met als basis het NVIDIA DGX Station-platform. De W775 is voorzien van de NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip.
De NVIDIA B300 Blackwell GPU, die via een C2C-verbinding is gekoppeld aan een Grace CPU, levert tot 20 petaFLOPs aan AI-prestaties voor veeleisende AI-workloads. Met tot 748 GB coherent systeemgeheugen (tot 252 GB HBM3e en 496 GB LPDDR5x van de CPU) kunnen ontwikkelaars experimenteren, finetunen of inferentie uitvoeren op grote modellen. Ze kunnen zelfs meerdere verschillende modellen tegelijkertijd uitvoeren om agent-gebaseede AI-toepassingen te creëren.
De meegeleverde NVIDIA ConnectX™ 8 SuperNIC maakt het mogelijk om meerdere NVIDIA DGX Station-systemen met elkaar te verbinden, zodat nog grotere workloads kunnen worden aangepakt en geavanceerde gedistribueerde rekenapplicaties kunnen worden gebouwd.
De W775 is uitgerust met tot 748 GB coherent systeemgeheugen, waardoor ontwikkelaars zelfs grote LLM’s lokaal kunnen uitvoeren (zoals Deepseek-R1, GPT-OSS-120B en Qwen2.5-235B). Daarmee kunnen ze lokaal inferentie uitvoeren op modellen met maar liefst 1T parameters, en de finetuning eveneens volledig lokaal uitvoeren.
Het platform is compatibel met een uitgebreid ecosysteem van tools: van toonaangevende frameworks zoals PyTorch, TensorFlow en Hugging Face Transformers, tot geoptimaliseerde inferentie-engines zoals SGLang en vLLM, tot fine-tuning-frameworks zoals LLaMA-Factory en Unsloth, evenals agent-frameworks, lokale inferentie-apps en end-to-end DevOps-tools.
Voor workloads die nog grotere modellen vereisen, beschikt de W775 over NVIDIA ConnectX™-netwerkfunctionaliteit, waarmee twee systemen kunnen worden geclusterd voor naadloze schaalbaarheid over meerdere knooppunten. Dit stelt ontwikkelaars in staat om verder te schalen dan één enkel knooppunt om grotere modellen en veeleisendere taken aan te kunnen, met behoud van een consistente softwareomgeving.
Daarnaast introduceert de Grace Blackwell-architectuur nieuwe optimalisaties, zoals NVFP4-precisie en speculatieve decodering, die de efficiëntie en reactiesnelheid verbeteren bij het uitvoeren van grootschalige generatieve AI-modellen. Dankzij deze vooruitgang kunnen ontwikkelaars snel prototypes maken en itereren, terwijl ze de mogelijkheid behouden om naadloos op te schalen naar grotere NVIDIA-platforms.
Van de cloud naar je bureau
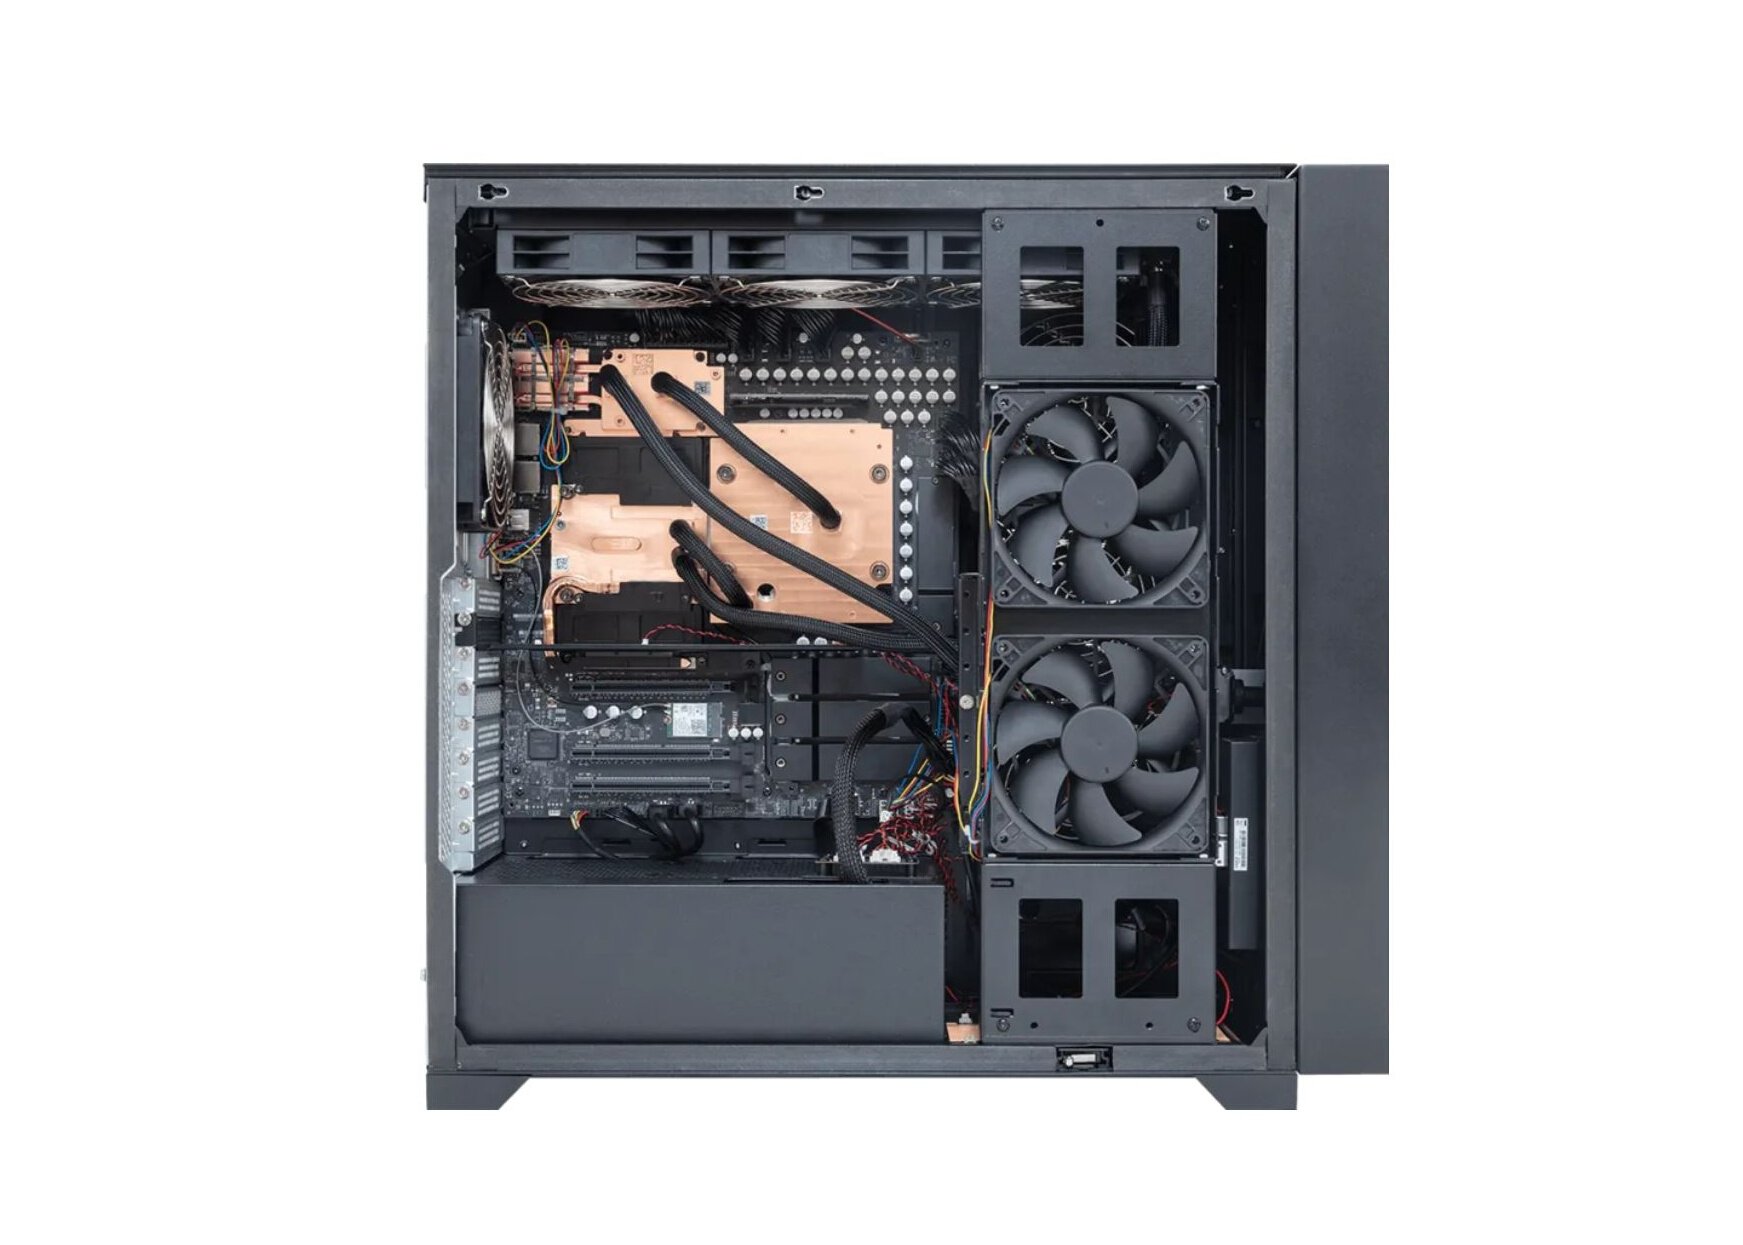
De GIGABYTE W775 is een krachtige AI-supercomputer voor op het bureau, die het mogelijk maakt lokaal prototypes van modellen en AI-toepassingen te ontwikkelen. Hij hoeft niet in een speciale ruimte te staan, en dankzij de waterkoeling blijft hij altijd stil, ook bij zware belasting. En het NVIDIA GB300-platform is gemaakt om naar wens eenvoudig uit te breiden, met meerdere W775-machines voor verschillende teams

Praat mee