
De grootste deeltjesversneller ter wereld produceert elke seconde tientallen terabytes aan data. Slechts een klein deel daarvan dient voor onderzoek. Om die datastroom in te dammen, combineert CERN eigen ontwikkelingen met opensource.
Lees verder na de advertentie
Van deeltjesbotsingen tot datastromen
Het grootste laboratorium voor deeltjesfysica ter wereld produceert hoeveelheden data die conventionele IT-infrastructuren tot het uiterste belasten. We beschrijven in dit artikel hoe CERN met opensource, innovatieve opslagarchitecturen en wereldwijde samenwerking het databeheer van de Large Hadron Collider (LHC) in goede banen leidt en welke uitdagingen de toekomst met zich meebrengt.
De LHC is een 27 kilometer lange ringversneller in een tunnel ongeveer 100 meter onder de grond, op de grens tussen Frankrijk en Zwitserland. Hij moet deeltjes laten botsen bij tot dusver ongekend hoge energieën om de fundamentele bouwstenen van de materie en de krachten daartussen te onderzoeken, zoals het Higgs-boson, dark matter en de asymmetrie tussen materie en antimaterie.
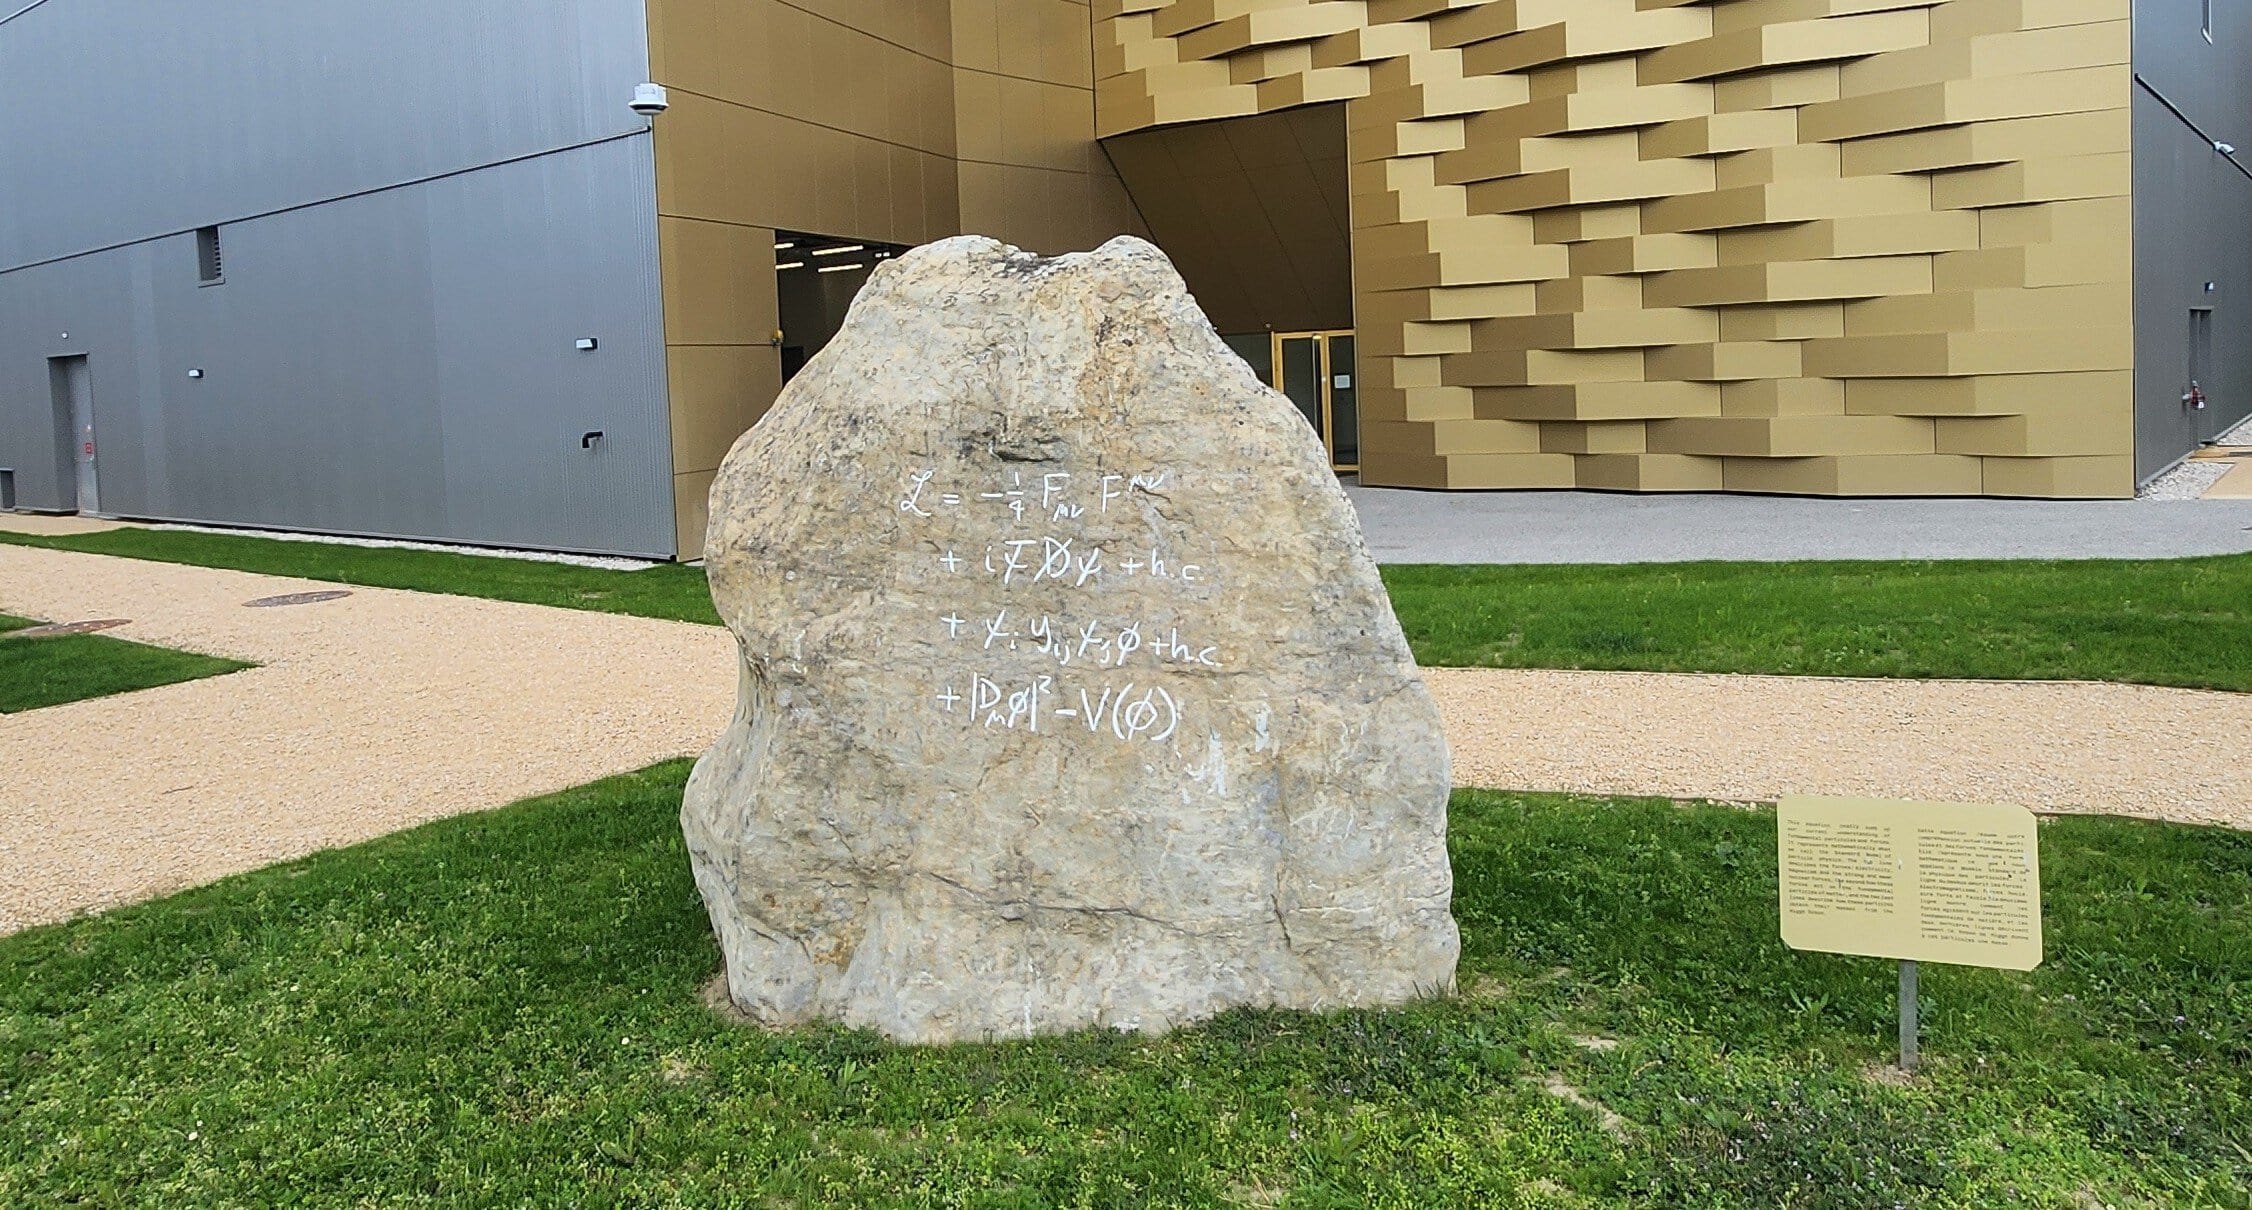
Als je het bezoekerscentrum van CERN nadert, krijg je meteen een voorproefje van die theoretische grondslagen: in de steen ervoor is de Lagrange-dichtheid van het standaardmodel van de deeltjesfysica gegraveerd (zie de openingsfoto).
De versneller wordt in verschillende fasen gebruikt, de zogeheten runs. Run 1 (2009 tot 2013) leidde tot de ontdekking van het Higgs-boson. Tijdens Run 2, van 2015 tot 2018, werden de energie en het aantal botsingen per seconde verhoogd. Run 3 (sinds 2022), die bij het verschijnen van dit artikel net was afgelopen, werkte met een nog hogere luminositeit (intensiteit of dichtheid van de deeltjesbundel) en leverde door het grotere aantal deeltjesbotsingen opnieuw aanzienlijk meer data op dan de voorgaande runs.
Alle door de LHC geproduceerde ruwe data opslaan is echter niet mogelijk en ook niet nodig. Bij proton-protonbotsingen in de LHC vinden ongeveer één tot twee miljard botsingen per seconde plaats. Elke gebeurtenis levert meerdere megabytes aan data op: een gigantische ruwe datastroom die de opslagcapaciteit van alle huidige systemen overstijgt.
Om die informatiestroom te beheersen, grijpen triggersystemen met meerdere niveaus in. Ze filteren uit alle botsingen alleen de wetenschappelijk interessantste. Een triggersysteem is een realtimefilter dat botsingen selecteert aan de hand van karakteristieke meetsignalen, bijvoorbeeld bijzonder energierijke deeltjes of ongebruikelijke deeltjespatronen, en alleen potentieel interessante gebeurtenissen doorlaat voor verdere analyse.
Veel opensource
CERN zet al jaren consequent in op opensource-oplossingen voor massaopslag, die deels zelf ontwikkeld zijn. Daardoor kan het onderzoekscentrum gericht inspelen op de eisen van de experimenten en samen met de opensourcegemeenschap innovaties stimuleren.
CERN Tape Archive (CTA) is het magneetbandopslagsysteem voor langdurige en kostenefficiënte archivering van wetenschappelijke data. Het beheert veel meer dan één exabyte aan data op tape en archiveert onderzoeksdata tientallen jaren lang, zodat ze indien nodig weer beschikbaar zijn. CTA is ontwikkeld als opensource opvolger van eerdere archiefsystemen en is ontworpen voor maximale schaalbaarheid en efficiëntie.
EOS Open Storage is het snelle, gedistribueerde opslagsysteem met harde schijven van CERN en is daar speciaal ontwikkeld voor de eisen van de hoge-energiefysica. Het biedt extreem hoge datadoorvoersnelheden, schaalbaar namespacebeheer (een catalogus van alle paden en bestandsnamen) en efficiënte toegang tot miljarden bestanden. Daardoor is EOS bijzonder geschikt voor het opslaan en analyseren van de grote hoeveelheden data die de experimenten produceren.
Daarnaast is er Ceph, een gedistribueerd objectopslagsysteem. Ceph speelt bij CERN een belangrijke rol als schaalbaar en uitvalbestendig platform voor object-, blok- en cloudnative-opslagtoepassingen. Ceph dient echter niet als backend voor EOS omdat het bij de specifieke workloads op exabyteschaal hogere bedrijfs- en infrastructuurkosten veroorzaakt dan het zelfontwikkelde EOS-platform.
Opslagmodel met meerdere niveaus
DRAM- en SSD-buffers die rechtstreeks op de LHC-detectoren zijn aangesloten, vangen de continu binnenkomende datastromen op. Op dat niveau staat een maximale schrijfsnelheid centraal om dataverlies te voorkomen en realtimeverwerking te waarborgen.
Bij het ALICE-experiment lezen first-level processors (FLP) de datastroom bijvoorbeeld met behulp van FPGA’s uit, met een ruwe datasnelheid van ongeveer 28 Tbit/s. Ze bundelen de data van talloze glasvezels en verkleinen de datastroom door irrelevante data en lege datapakketten te verwijderen. Daarbij blijft ongeveer 20 procent van de data over.
Vervolgens sturen ze maximaal 5,4 Tbit/s (679 GB/s) door naar een GPU-farm. ALICE legt de data continu vast in tijdvakken van 20 milliseconden. Terwijl andere experimenten afzonderlijke gebeurtenissen met triggers selecteren en uitlezen, verwerkt ALICE de gehele datastroom doorlopend, vergelijkbaar met een filmcamera met een constante beeldsnelheid.
Het opslagsysteem EOS is de centrale opslag voor fysicadata en biedt momenteel ongeveer 1,16 exabyte aan opslagruimte op harde schijven, verdeeld over tientallen instanties. De gegevensoverdrachtssnelheid van het totale systeem is ongeveer 1 TB/s. In totaal staan er circa 8,7 miljard bestanden op de servers.
De grootste EOS-instantie, voor het ALICE-experiment, slaat 150 PB aan data op met erasure-coding in het 10+2-formaat, met dubbele pariteit en 20 procent capaciteitsoverhead. Die technische keuze vormt een compromis tussen aanvaardbaar ‘herstelverkeer’ en ‘capaciteitsoverhead’ en heeft zich in de praktijk goed bewezen. Er wordt echter overwogen om uit kostenoverwegingen met minder capaciteitsoverhead te experimenteren, bijvoorbeeld met het erasure-coding-formaat 16+2.
Dankzij de relatief hoge bescherming tegen dataverlies staat CERN een gebruiksduur van maximaal tien jaar per schijf toe. Dat is tweemaal zo lang als de garantieperiode die fabrikanten doorgaans voor enterpriseschijven hanteren.
Voor archivering worden de data naar tapes overgebracht. Tapelibrary’s bewaren enorme hoeveelheden data tientallen jaren lang tegen lage kosten en met een laag energieverbruik. CERN rekent voor de archivering op ongeveer 10 tot 25 procent van de kosten van een systeem met harde schijven.
Ongeveer twee derde van de archiveringskosten bestaat uit de aanschafprijs van de tapes, de rest gaat naar de infrastructuur. De tapecapaciteit bedraagt momenteel circa 1,7 exabyte – alleen al Run 3 leverde ongeveer 1 exabyte aan data op.
De Ceph-opslag heeft een relatief kleine capaciteit. Naast ongeveer 133 petabyte aan ruimte op harde schijven biedt het systeem circa 10 petabyte aan SSD-opslag voor snellere toegang.
Ceph wordt vooral gebruikt als backend voor infrastructuurdiensten met hoge beschikbaarheidseisen. Daaronder vallen bijvoorbeeld de CERN-website en virtuele machines met OpenStack. Daarnaast dient Ceph als objectopslag voor GitLab, Kubernetes en OpenShift.
Elke laag van de hiërarchie vervult een specifieke taak: DRAM- en SSD-buffers zorgen voor snelheid, harde schijven dienen voor analyse en snelle toegang, en tape biedt zekerheid op de lange termijn.
Daarnaast spiegelt CERN de data naar het Worldwide LHC Computing Grid (WLCG). CERN beheert die wereldwijd verspreide rekeninfrastructuur samen met meer dan 170 datacenters in ruim 40 landen om de enorme hoeveelheden data van de Large Hadron Collider op te slaan, te verspreiden en te analyseren. Duizenden natuurkundigen gebruiken het voor simulaties en analyses.
Het WLCG combineert ongeveer 1,3 miljoen rekenkernen met meer dan 4 exabyte aan opslag, verwerkt miljoenen rekentaken per dag en haalt gegevensoverdrachtssnelheden van ruim boven de 200 GB/s. Het WLCG gebruikt daarbij een gelaagd model om de data zo efficiënt mogelijk te verdelen: Tier 0 bevindt zich binnen CERN, Tier 1 bestaat uit nationale centra en Tier 2 uit de daarbij aangesloten universiteiten.
Metadata, bestandsformaten en langetermijnarchivering
Data zijn alleen bruikbaar als ze vindbaar blijven en correct geïnterpreteerd kunnen worden. Daarom documenteert CERN de meetgegevens met uitgebreide metadata, bijvoorbeeld over de detectorstatus, tijdstempels en triggervoorwaarden. De opslag vindt vaak plaats in het ROOT-formaat, dat CERN speciaal heeft ontwikkeld voor de verwerking van grote hoeveelheden data in de deeltjesfysica.
Momenteel staat de invoering van RNTuple op de agenda, een nieuw kolomgeoriënteerd dataformaat binnen het ROOT-ecosysteem dat is ontwikkeld voor sterk parallelle analyses en efficiënt gebruik van moderne opslagsystemen. RNTuple werkt met transformatiefilters en moderne compressiebibliotheken zoals ZSTD, wat zowel de prestaties als het benodigde opslagvolume verder optimaliseert. In veel toepassingen heeft RNTuple 40 tot 50 procent minder opslagruimte nodig dan het TTree-formaat van ROOT.
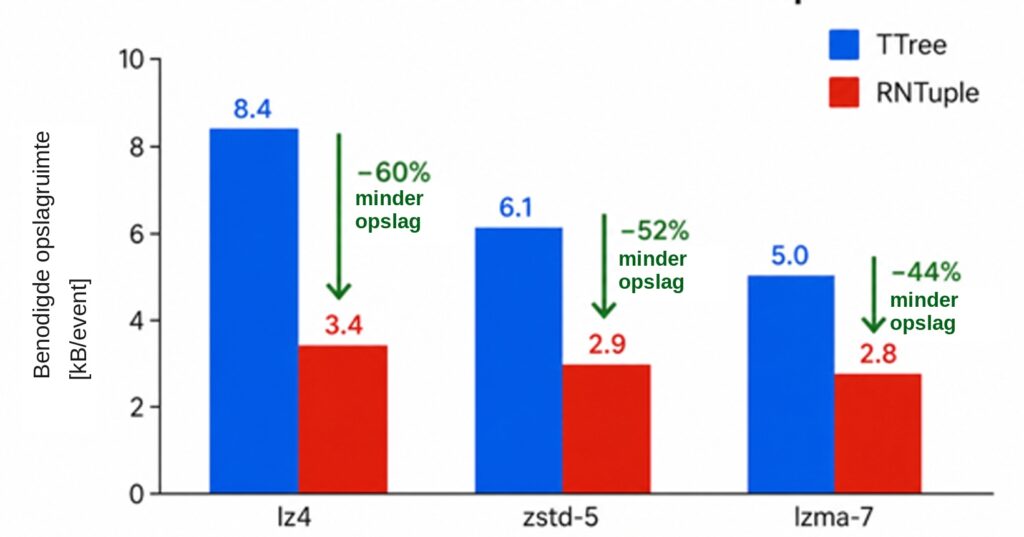
Bijschrift: Een ander compressiealgoritme en de overstap van het TTree- naar het RNTuple-formaat verminderen de benodigde opslagruimte voor de LHC-data. (Afbeelding CERN)
Langetermijnarchivering
Een nadeel van archivering op tape is de inmiddels beperkte compatibiliteit van de LTO-standaard. De jarenlang geldende regel ‘twee generaties terug lezen, één generatie terug schrijven’ werd vanaf LTO-9 beperkt. De huidige LTO-10-drives kunnen helemaal geen tapes van eerdere generaties meer lezen. Voor veel beheerders van tapeopslag betekent dit dat ze voor de overstap naar de huidige versie niet alleen nieuwe drives en media moeten aanschaffen, maar ook een tweede tape-infrastructuur moeten opbouwen.
Het tientallen jaren veiligstellen van onvervangbare onderzoeksdata vereist bovendien regelmatige migratie naar andere media, checksums, redundantie en zorgvuldige documentatie, alleen al om de leesbaarheid in toekomstige systemen te waarborgen. Daarnaast moeten de data redundant op verschillende locaties worden bewaard.
CERN beproeft regelmatig nieuwe opslag- en archiveringstechnieken in samenwerking met industriepartners zoals IBM, Siemens en Everpure, en met innovatieve start-ups zoals Cerabyte. In het kader van CERN openlab werkt het opslagteam van CERN samen met Cerabyte aan de verdere ontwikkeling van een op keramiek gebaseerd systeem voor langetermijnarchivering.
Duurzaamheid ondanks toenemende eisen
De energiebehoefte van de opslagsystemen is gering vergeleken met die van de versnellerinstallaties. Tape heeft bijvoorbeeld alleen tijdens het lezen en schrijven energie nodig. De meeste tapes worden wel bewaard in een geklimatiseerde omgeving met vastgelegde condities. Door harde schijven gericht uit te schakelen [1] kan veel energie worden bespaard, vooral bij grote aantallen. CERN onderzoekt momenteel samen met een partner hoe dat voor JBOD’s gerealiseerd kan worden.
Het nieuwe CERN-datacenter in Prévessin zet voor een duurzame IT-infrastructuur in op warmteterugwinning en een lage Power Usage Effectiveness (PUE). De PUE geeft de verhouding weer tussen het totale opgenomen vermogen van het datacenter, inclusief verlichting en koeling, en het elektrische vermogen dat de eigenlijke IT-infrastructuur verbruikt, bijvoorbeeld de servers. De beoogde PUE voor Prévessin is een lage 1,1. Het datacenter neemt dus slechts 10 procent meer vermogen op dan de IT-apparatuur nodig heeft.
Het warmteterugwinningssysteem moet vanaf komende winter de gebouwen op het terrein verwarmen met de restwarmte van het datacenter en zo een belangrijke bijdrage leveren aan een hogere energie-efficiëntie. Het grootste deel van de opslag van CERN staat momenteel echter in het datacenter in Meyrin.
HL-LHC, FCC en de toekomst van de opslaginfrastructuur
Run 3 van de LHC is afgelopen. De deeltjesversneller bevindt zich momenteel in een ombouwfase die Long Shutdown 3 wordt genoemd, kortweg LS 3. Met de geplande ingebruikname van de High-Luminosity LHC (HL-LHC, Runs 4 en 5) rond 2030 worden datavolumes tot één exabyte per jaar verwacht. De onderzoekers verwachten de grootste knelpunten bij de I/O-snelheden, de langetermijnarchivering en de bandbreedte van het grid.
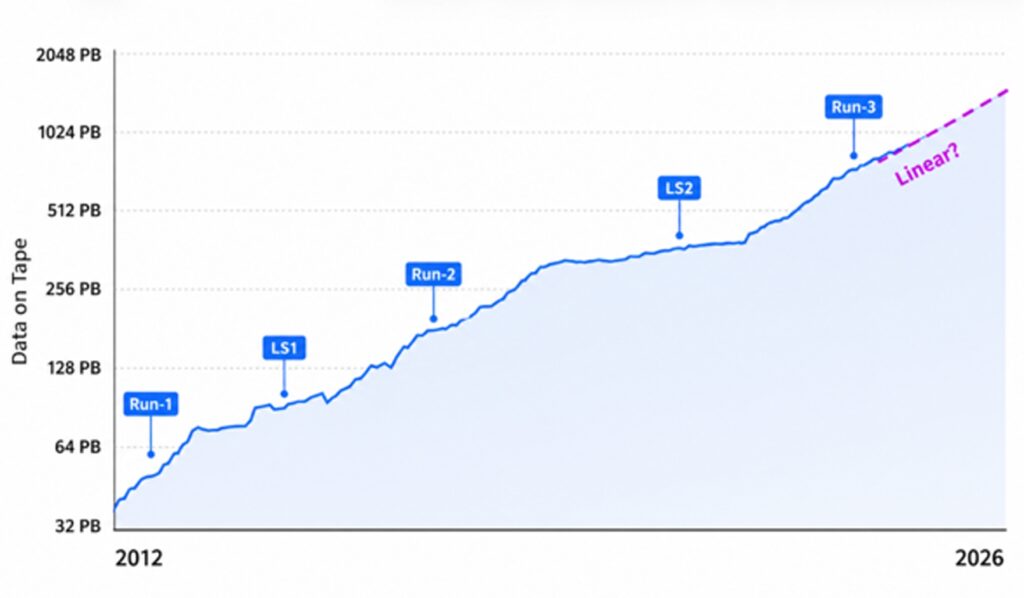
CERN investeert daarvoor al in nieuwe tapetechnieken, geautomatiseerde archiefsystemen en hybride opslagarchitecturen met SSD’s, harde schijven en tapes. Algoritmen voor machine-learning identificeren data op harde schijven die al lange tijd niet gebruikt zijn en daarom naar goedkopere tapeopslag kunnen worden verplaatst. De belangrijkste uitdagingen zijn de ontwikkeling van schaalbare opslagoplossingen, verdere automatisering van het databeheer en een hoge energie-efficiëntie.
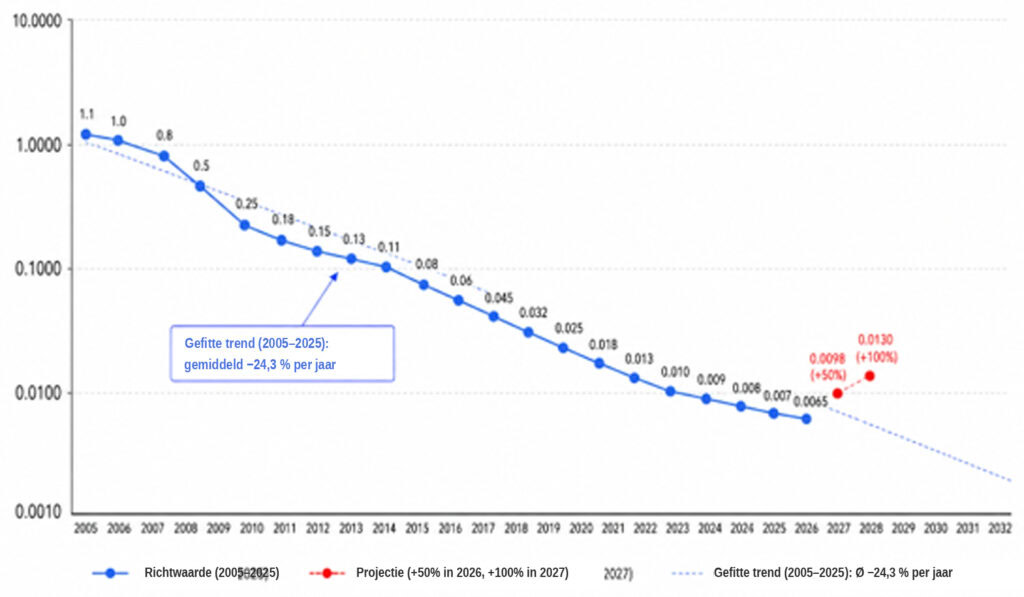
De door de AI-boom sterk gestegen prijzen van harde schijven en opslaghardware bemoeilijken ook de uitbreiding van wetenschappelijke infrastructuren. Jarenlang gold voor opslag een aangepaste wet van Moore, met een jaarlijkse capaciteitstoename van minstens 20 procent bij gelijkblijvende kosten. Sinds begin 2026 zijn de prijzen van harde schijven bij de hardware-aanbestedingen van CERN echter met ongeveer 50 procent gestegen. Voor 2027 worden verdere prijsstijgingen verwacht.
Het huidige LHC-programma, inclusief de HL-LHC, moet tot in de jaren 2040 doorlopen. Daarna moet de Future Circular Collider (FCC), een deeltjesversneller van de volgende generatie, het onderzoek bij CERN voortzetten. De lidstaten van CERN moeten echter nog instemmen met die uitbreiding.
Bij de eerste uitbreidingsfase, FCC-ee, wordt bij een klassieke uitlezing met triggers ongeveer 40 GB/s verwacht, dus vergelijkbare datavolumes als bij de HL-LHC. Er wordt echter ook overwogen om de data als continue stroom uit te lezen met ongeveer 100 GB/s, of zelfs volledig ongefilterd met maximaal 10 TB/s.
Daarnaast kunnen de datasnelheden van de toekomstige FCC-hh de huidige eisen ruimschoots overtreffen, met maximaal 250 TB/s voor calorimeter- en muonsystemen en maximaal 2 PB/s voor trackers. Dergelijke datavolumes zullen waarschijnlijk aanzienlijke technische uitdagingen met zich meebrengen.
De bij CERN ontwikkelde opensource opslagsystemen met hoge prestaties zijn echter goed toegerust om die uitdagingen aan te gaan. Het toenemende gebruik ervan buiten de deeltjesfysica versterkt bovendien hun bijdrage aan het Europese wetenschaps- en technologielandschap.
Andreas Peters en Noud van Kruysbergen
Literatuur
[1] Lutz Labs en Noud van Kruysbergen, Energiebesparing bij grote schijf-arrays, c’t 6/2026, p.123

Praat mee