
AI verandert de security in de IT – de vraag is of het dit ten goede of ten kwade doet? Het is in ieder geval een misvatting om AI uitsluitend als een bedreiging voor de IT-beveiliging te zien. AI is niet eens het daadwerkelijke probleem en kan juist helpen bij het oplossen ervan.
AI legt de zwakke fundamenten van IT-beveiliging bloot
De IT-security ondergaat momenteel een transformatie zoals we die in de afgelopen twintig jaar niet hebben gezien. De veranderingen, ontwrichtingen, maar ook kansen die hieruit voortvloeien, zijn enorm. Wie dit negeert, zal enorme problemen krijgen om de IT-operaties überhaupt draaiende te houden. Het draait om artificiële intelligentie en de groeiende invloed die deze heeft op discussies en aanpak binnen de IT-beveiliging.
Daarbij is de steeds beter wordende AI niet eens het fundamentele probleem. Het daadwerkelijk probleem wordt gevormd door de structureel slordige beveiligingsaanpak in de afgelopen decennia. Al onze software, onze hardware en natuurlijk alle daarop gebaseerde diensten zijn onveilig en bevatten beveiligingslekken waarvan we nog niets weten. Wie deze beveiligingslekken kent en kan misbruiken, kan praktisch naar wens systemen compromitteren, gegevens stelen en nog veel meer.
Het enige wat dit in de weg staat, is het feit dat het vrij moeilijk is om dergelijke beveiligingslekken te vinden en er vervolgens effectief misbruik van te maken. Dat vereist kennis en vaardigheden waar maar weinig mensen over beschikken. Gelukkig hebben de meeste experts wel iets beters te doen dan in te breken in de systemen van anderen. Onze veiligheid berust dus op het feit dat er maar weinig echt gekwalificeerde en kwaadwillige hackers zijn.
LLM’s kunnen hacken
Alleen blijkt nu plotseling dat Large Language Models (LLM’s) beveiligingslekken kunnen opsporen en er zelfs misbruik van maken. Bij de eerste pogingen in deze richting gingen de AI’s nog enigszins onhandig te werk.
De ommekeer kwam begin 2026 met een experiment van de gerenommeerde onderzoeker en beveiligingsexpert Sean Heelan (informatie over de genoemde bronnen via de link bij dit artikel). Hij bouwde een testomgeving waarin de toonaangevende LLM’s van Anthropic en OpenAI moesten laten zien of ze in staat waren een zogenaamd zero-day-lek te vinden en dit vervolgens ook uit te buiten.
Het ging erom eigen code in het testsysteem te kunnen infiltreren en uitvoeren. Deze Remote Code Execution (RCE) is als het ware de heilige graal van het kwetsbaarheidsonderzoek, omdat het mogelijk maakt om systemen van buitenaf te kapen.
Heelans onderzoek verschilde op een aantal belangrijke punten van eerdere experimenten. De aan te vallen software was een JavaScript-runtime-omgeving (QuickJS), en dus niet eenvoudige programma’s ter demonstratie, maar echte, redelijk complexe software. Bovendien was het beveiligingslek dat er in zat nog niet openbaar bekend en er was nog geen fix voor, wat betekende dat het LLM het niet ergens kon ‘afkijken’. Het LLM moest het beveiligingslek daadwerkelijk zelf vinden, vervolgens zelf code ontwikkelen die in staat was het lek uit te buiten en uiteindelijk de mogelijkheid tot RCE aantoonde.
Heelan documenteerde zowel de opzet van de test als de resultaten ervan minutieus. Hij stelde de betrokken code en alle prompts ter beschikking, zodat andere experts zijn resultaten niet alleen konden inspecteren, maar ook zelf konden nagaan en controleren. Deze resultaten hebben vervolgens de beveiligingswereld op zijn kop gezet.
De Vulnpocalyps
Op het eenvoudige beveiligingsniveau slaagden zowel Opus 4.5 als GPT 5.2 er vrijwel onmiddellijk in om het beveiligingslek uit te buiten. De LLM’s konden zonder veel moeite een eenvoudige sandbox op basis van het seccomp-mechanisme van Linux omzeilen, die onder andere ongeoorloofde schrijfbenaderingen moet voorkomen.
De laatste test vond plaats in de hardcore-modus, waarbij alle state-of-the-art beveiligingsmaatregelen waren geactiveerd die het misbruiken van kwetsbaarheden in de praktijk inmiddels te moeilijk maken: Address Space Layout Randomization, Control Flow Integrity en nog enkele andere (het maakt niet uit als je niet weet wat dit precies inhoudt – het belangrijkste is: het doelwit was goed verdedigd).
Ondanks al deze maatregelen had GPT 5.2 slechts ongeveer drie uur en tokens ter waarde van ongeveer 50 dollar nodig om volledige Remote Code Execution te bereiken. Wat eigenlijk nog het meest verrassend was, was niet dit resultaat, maar de algemene conclusie van Heelan: “het vermogen [om exploits te ontwikkelen] wordt beperkt door het aantal tokens dat daarvoor wordt ingezet.”
Daarmee was een keerpunt bereikt. LLM’s maken een tot nu toe onvoorstelbare industrialisering van het onderzoek naar kwetsbaarheden mogelijk. De mens als beperkende factor speelt geen rol meer, de basis van onze beveiliging is aan het wankelen gebracht.
Vervolgens presenteerde Anthropic Mythos, het tot nu toe krachtigste LLM, althans wat betreft het vermogen om beveiligingslekken te misbruiken. De presentatie van Mythos ging gepaard met duizend nieuwe, deels spectaculaire zero-day-kwetsbaarheden, inclusief bijbehorende exploits, die aantonen dat en op welke manier de kwetsbaarheden kunnen worden misbruikt. Wat Mythos specifiek onderscheidt, is zijn vermogen om in ingewikkelde situaties deeloplossingen te vinden en deze zodanig met elkaar te combineren dat zelfs complexe taken uiteindelijk met succes worden uitgevoerd.
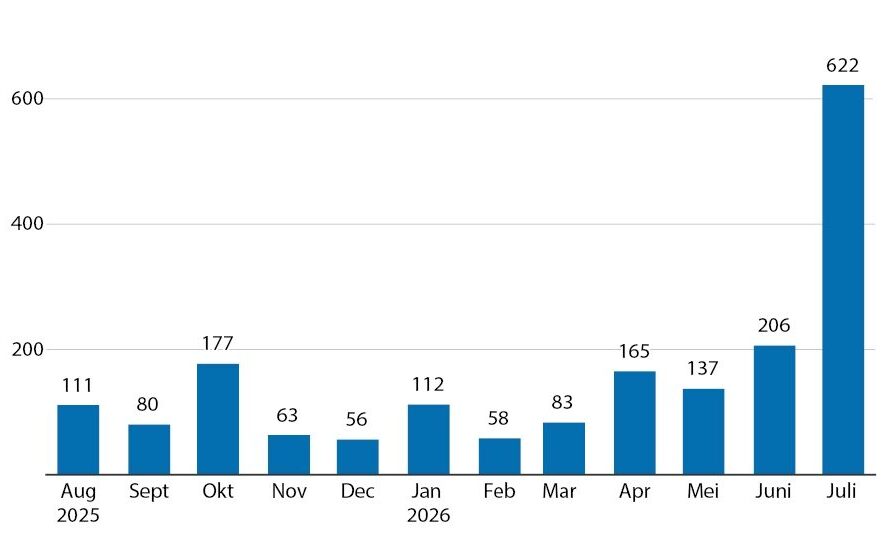
Inmiddels heeft deze stortvloed aan kwetsbaarheden de fabrikanten en daarmee ook de gebruikers bereikt. De Mozilla-ontwikkelaars, die doorgaans 20 tot 30 bugs per maand verhelpen, hebben alleen al in april van dit jaar 423 bugs verholpen! Op de patchdagen van Microsoft krijgen beheerders doorgaans te maken met 50 tot 150 te installeren patches; in juli waren dat er in één klap maar liefst 622.
Deze stortvloed treft zonder enige uitzondering alle fabrikanten en opensourceprojecten – en natuurlijk ook hun gebruikers. Iedereen klaagt over een aantal bugs en patches dat nauwelijks nog te behappen is (zie het volgende artikel in deze reeks Hoe AI opensourcebeheerders onder druk zet). Deze zogenaamde Vulnpocalyps is al in volle gang. De gapende beveiligingshiaten van de afgelopen decennia staan wagenwijd open.
Microsoft-Patchdays: gedichte beveiligingslekken
Juli was een recordmaand. De cijfers over de patches van Microsoft zijn afkomstig uit de maandelijkse Patchday-rapporten van heise security. Ze komen grotendeels overeen met andere bronnen, zoals Trend Micro’s ZDI.
De volgende stap
Veel experts merken op dat kwetsbaarheden en het misbruik daarvan slechts een deel van de IT-beveiliging betreffen. En ze hebben gelijk: bij echte aanvallen vergemakkelijken deze mogelijkheden slechts een klein deel van de zogenaamde ‘kill chain’: de eerste toegang (Initial Access). Zelfs daar spelen social engineering, het stelen van wachtwoorden en configuratiefouten een minstens net zo grote rol als technische exploits.
In de volgende fasen – het verhogen van de bevoegdheden, het zich permanent nestelen, de verdere verspreiding en de uiteindelijke impact – neemt het belang van de exploits zelfs steeds verder af. Om belangrijke gegevens te versleutelen of weg te sluizen heeft de aanvaller geen beveiligingslekken meer nodig; hij is op dat moment immers meestal beheerder van het systeem of zelfs van het domein. Hij hoeft dus alleen maar een geschikt programma te installeren en uit te voeren om zijn doel te bereiken.
Maar het blijkt steeds vaker dat LLM’s ook deze aanvalsstappen kunnen plannen en uitvoeren – en dat grotendeels zelfstandig. Al eind 2025 meldde Anthropic dat overheidsgerelateerde, vermoedelijk Chinese aanvallers, de AI Claude van Anthropic hadden misbruikt om complexe aanvallen grotendeels autonoom uit te voeren (zie de link bij dit artikel). De mens trad daarbij op de achtergrond en deelde alleen nog maar algemene taken uit; het eigenlijke werk werd door het LLM gedaan.
Er is alleen een probleem met dit verhaal. Anthropic deed slechts vrij algemene beweringen en liet zich niet overhalen om deze ook te onderbouwen met concrete beschrijvingen van de feiten. De fabrikant maakte noch de gebruikte prompts, noch de daadwerkelijk door het LLM uitgevoerde acties bekend. Daardoor konden de uitspraken niet worden gecontroleerd, kon hun betekenis niet goed worden ingeschat en kon er uiteindelijk ook niets uit worden geleerd. Een typische PR-stunt.
Dat veranderde pas in april 2026, toen Gambit Security toegang kreeg tot de infrastructuur van een aanvaller en nauwkeurig documenteerde dat – en vooral hoe – een enkele aanvaller kon inbreken in de netwerken van Mexicaanse overheidsinstanties. Gambit documenteerde tot op promptniveau hoe de aanvaller met behulp van twee LLM’s enkele honderden overheidsservers kaapte en onder andere de belastinggegevens van meer dan honderd miljoen Mexicanen in zijn bezit kreeg. Een enkele, op zijn best gemiddeld begaafde hacker had in ongeveer twee weken iets voor elkaar gekregen waar normaal gesproken een team van specialisten meerdere maanden mee bezig was geweest. Het patroon van de exploits herhaalt zich ook op dit niveau.
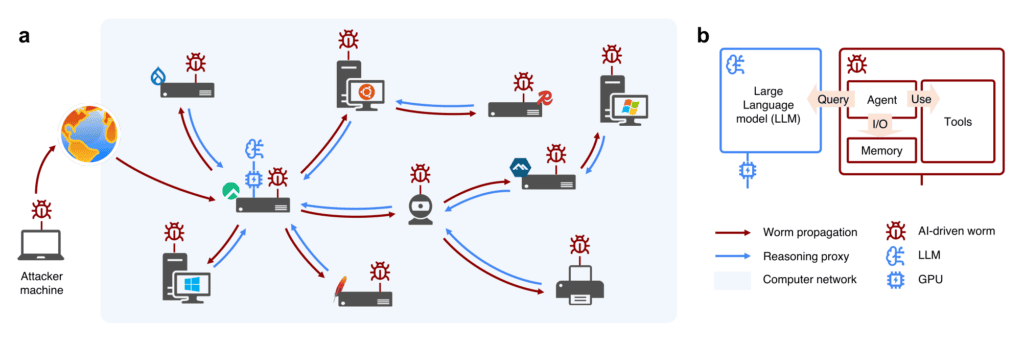
In juni presenteerde de Universiteit van Toronto een AI-worm die – in ieder geval in het laboratorium in een testnetwerk – met succes Linux- en diverse IoT- en Windows-systemen kaapte om zich vervolgens volledig autonoom verder te verspreiden. Het bijzondere aan de Toronto-worm is dat hij op gecompromitteerde systemen met een GPU zijn eigen LLM installeerde, waarmee hij zichzelf vervolgens uitvoerde. Hij bracht dus als het ware zijn eigen brein mee.
In juli documenteerde Sysdig bovendien de eerste ransomware-aanval die volledig door een LLM was gepland, aangestuurd en uitgevoerd. Die was nog behoorlijk amateuristisch; de AI ‘vergat’ bijvoorbeeld de sleutel op te slaan die voor de versleuteling werd gebruikt. Bovendien bleek het Bitcoin-walletadres voor de overmaking van het losgeld niet van de aanvaller te zijn, maar afkomstig te zijn uit openbaar toegankelijke documentatie die in de training van de LLM was verwerkt.
De ongelooflijke OpenAI-mislukking
Maar zelfs bij de laatste sceptici verstomde hun lach toen een echt topmodel in actie kwam: eind juli evalueerde OpenAI de capaciteiten van zijn nieuwste LLM’s – waaronder een nog niet gepubliceerd model – met een systematische test voor het opsporen en misbruiken van beveiligingslekken, de ExploitGym. Daartoe schakelden de ontwikkelaars bewust de guardrails van de modellen uit, die ingebouwd zijn om dergelijke potentieel gevaarlijke activiteiten te voorkomen.
In plaats daarvan sloten ze de LLM’s op in een testkooi, waarin ze geen schade zouden kunnen aanrichten. Volgens de door OpenAI gepubliceerde beschrijving van het volgende incident zocht en vond een van de LLM’s echter een beveiligingslek in de testomgeving, waardoor het zich vrije toegang tot het internet kon verschaffen. De AI maakte hiervan gebruik om de AI-hostingservice Hugging Face (HF) aan te vallen, blijkbaar met als doel daar datasets en vooral oplossingen voor de test te vinden.
Vervolgens uploadde de AI een speciaal voor dit doel gemaakte, kwaadaardige dataset naar HF, die uit hun sandbox ontsnapte, inloggegevens stal en zich verder verspreidde binnen de HF-infrastructuur. Volgens OpenAI is de AI er daadwerkelijk in geslaagd om bij HF gegevens te stelen waarmee deze de testresultaten kon manipuleren.
Allereerst moet worden vastgesteld dat op basis van de eigen uitspraken, OpenAI zich ronduit dom heeft gedragen. Dat een AI die zonder beveiligingsbeperkingen opereert en de opdracht heeft om beveiligingslekken op te sporen en te misbruiken, dit in de eigen testomgeving zou proberen, had de AI-experts van begin af aan duidelijk moeten zijn. Dat men deze aanvallen niet heeft voorkomen en ze gedurende meerdere dagen niet eens heeft opgemerkt, kan op zijn best nog als grove nalatigheid worden bestempeld.
Het toont in ieder geval op indrukwekkende wijze aan hoe goed LLM’s inmiddels in staat zijn om complete aanvallen te plannen en op eigen houtje uit te voeren. Tot nu toe zijn dit nog afzonderlijke voorbeelden met telkens specifieke voorwaarden en beperkingen. Maar het laat heel duidelijk zien waar de reis naartoe gaat: al binnen enkele maanden zullen zelfs minder begaafde aanvallers met behulp van AI opereren op een niveau waarop securityspecialisten en hun IT-afdelingen niet zijn voorbereid. Dat wordt het nieuwe normaal, waarop iedereen zich nu moet voorbereiden.
Dit klinkt allemaal zozeer als sciencefiction dat je daarbij gemakkelijk de grenzen van AI uit het oog verliest. Maar die zijn er wel – en ze maken het probleem oplosbaar. Zo creëert AI, tot nu toe althans, uiteindelijk niets echt nieuws. De soorten kwetsbaarheden van alle gaten die AI vindt, zijn in principe al bekend: bufferoverloop, logische fouten, verkeerde configuraties, enzovoort. Een LLM zal geen echt nieuwe soorten fouten aan het licht brengen, zoals bijvoorbeeld de spectaculaire side channel-aanvallen Spectre en Meltdown in 2018 deden, die speculatieve code-uitvoering in cpu’s mogelijk maakten.
Hetzelfde geldt voor het misbruiken van beveiligingslekken en het coördineren van aanvallen. De LLM’s putten uit bekend materiaal en passen dit verbazingwekkend goed en efficiënt toe op het betreffende probleem. Het is mogelijk dat AI op een dag ook deze grens doorbreekt – maar daarvoor zou waarschijnlijk een nieuwe generatie nodig zijn; tot nu toe zijn er geen aanwijzingen dat de LLM’s die gespecialiseerd zijn in Next Token Prediction hiertoe in staat zouden zijn.
Een sprankje hoop en misvattingen
Bovendien is het aantal bestaande beveiligingslekken beperkt. Alle kwetsbaarheden die verdedigers – eventueel met behulp van AI – hebben gevonden en verholpen, kunnen aanvallers niet meer misbruiken. Dat hebben ook de grote AI-bedrijven ingezien. Met Glasswing en Aardvark/Codex Security hebben Anthropic en OpenAI projecten in het leven geroepen die softwareontwikkelaars, ook in de opensource-sector, helpen hun software met behulp van AI veiliger te maken (zie het artikel over de ‘Vulnpocalypse’ in deze reeks). Bovendien is er een bloeiende markt van AI-start-ups zoals AISLE, ZeroPath, Xint Code, Seal Security, XBOW en nog veel meer, met deels creatieve benaderingen om software veiliger te maken. En ten slotte spannen ook de gevestigde fabrikanten van beveiligingsproducten zich in om deze met AI te verbeteren of aan te vullen.
Het addertje onder het gras is echter dat het bij de verdedigers veel langer zal duren om deze upgrades door te voeren dan bij de aanvallers, omdat de eisen – met name op het gebied van betrouwbaarheid en kwaliteit – hoger liggen. Het maakt de aanvallers niet uit of hun activiteiten diensten lamleggen. Maar bij het opsporen en verhelpen van kwetsbaarheden in productiesystemen zal men in de nabije toekomst niet helemaal kunnen afzien van de zogenaamde ‘human-in-the-loop’, die in geval van twijfel voorkomt dat een overijverige AI zomaar een database wist die voor het voortbestaan van het bedrijf essentieel is. Er zal nog heel wat onderzoek en ontwikkeling moeten plaatsvinden voordat verdedigers AI’s echt autonoom kunnen laten opereren.
Bij sommige oplossingen is het bovendien nu al duidelijk dat ze het probleem weliswaar zullen verzachten, maar niet zullen oplossen – als ze dat al doen. Het zal bijvoorbeeld onvermijdelijk averechts werken om bijzonder ‘gevaarlijke’ LLM’s zoals Mythos achter slot en grendel te houden of de toegang te beperken met guardrails. Dat zal er uiteindelijk alleen maar toe leiden dat aanvallers AI grotendeels vrij kunnen gebruiken, terwijl de verdedigers worstelen met beperkingen die hun werk enorm belemmeren.
Dit werd bijzonder treffend gedemonstreerd door de eerder genoemde OpenAI-fail. Terwijl hun AI namelijk zonder guardrails Hugging Face aanviel, constateerde HF dat de AI’s van Frontier Labs weigerden hen te helpen bij de analyse van de aanval. Dat was in strijd met de beveiligingsrichtlijnen, zo werd de verdedigers verteld, die al zwaar onder vuur lagen. HF zag zich uiteindelijk genoodzaakt zelf een lokaal, open model te installeren – van een Chinese aanbieder!
Af en toe lees je ook dat de stortvloed aan kwetsbaarheden te wijten zou zijn aan de beschikbaarheid van de broncode bij opensourcesoftware (OSS). “Opensourcecode is in feite hetzelfde als het overhandigen van de bouwtekening voor een bankkluis“, zo motiveert Bailey Pumfleet, CEO van het bedrijf Cal.com, de overstap naar closed-source.
Het is waar dat de meeste tests gebruikmaken van OSS. Maar dat is vooral te wijten aan het gemak; LLM’s kunnen ook machinecode analyseren. In geval van twijfel vertalen ze deze met tools zoals Ghidra terug naar een beter leesbare hogere taalcode. Dat hebben de onderzoekers van Team82 al met succes gedemonstreerd met de toegangsbeveiligingsoplossing van Zenitel. Closed-source mag dan een extra hindernis zijn, maar het zal LLM’s niet lang kunnen tegenhouden. Bovendien is opensourcesoftware vaak op grote schaal aanwezig in toeleveringsketens, ook bij bedrijven die zelf geen opensourcesoftware produceren.
Conclusie
Het is in ieder geval een geruststelling dat AI geen geheel nieuwe problemen aan het licht brengt. Dat betekent namelijk dat de oplossingen in principe ook al bekend zijn. Dat betekent echter ook dat AI niet een wondermiddel is tegen al onze beveiligingsproblemen.
AI is niet de oorzaak van de problemen en kan evenmin de algemene oplossing ervoor zijn. Het is een hulpmiddel dat bij sommige aanpakken weinig nut heeft of zelfs schadelijk kan zijn, terwijl het andere aanpakken juist aanzienlijk kan verbeteren.
Zo zal de noodzakelijke versnelling van de patch- en updatecycli zonder AI-ondersteuning nauwelijks lukken. In het ideale geval zal AI er ook toe bijdragen dat in de toekomst een groot deel van de kwetsbaarheden al wordt verholpen voordat de software überhaupt bij de gebruiker terechtkomt.
Voor het opsporen en verwijderen van oude kwetsbaarheden is doorgaans geen AI nodig, maar een systematische aanpak en daadkracht. En als het er bijvoorbeeld om gaat een aanvaller tijdig in het eigen netwerk te detecteren, blijken eenvoudige valstrikken – zogenaamde honeypots en deception-tools – vaak betrouwbaarder te zijn dan de anomaliedetectie van een AI. Het belangrijkste is echter dat men nu aan de slag gaat en de beveiligingsachterstanden van de afgelopen decennia eindelijk aanpakt.
Jürgen Schmidt en Daniel Dupré
Links bij dit artikel
On the Coming Industrialisation of Exploit Generation with LLMs
Experiment van de gerenommeerde onderzoeker en beveiligingsexpert Sean Heelan
Anamnesis: LLM Exploit Generation Evaluation
Code en prompts voor het experiment van Heelan
Disrupting the first reported AI-orchestrated cyber espionage campaign
Anthropic-rapport over misbruik van Claude
A Single Operator, Two AI Platforms, Nine Government Agencies: The Full Technical Report
Gambit-rapport over de aanval op Mexicaanse overheidsinstanties
AI Agents Enable Adaptive Computer Worms
AI-worm van de Universiteit van Toronto (PDF)
Jadepuffer: The first AI ransomware attack not only messes up the key
Artikel van heise online over de eerste door LLM aangestuurde ransomware-aanval
Cal.com gaat closed source. Dit is waarom.
Cal.com over de overstap naar closed source
Hands Free: What LLM Driven Vulnerability Research Looks Like
Team82-rapport over reverse engineering
Praat mee