
Gegenereerde melanomen: AI-beeldgenerators creëren mooie graphics en realistische foto’s. Maar wie wil er nu afbeeldingen van huidkanker genereren? Dr. Stanislav Frolov legt uit waarom dat zinvol is.
Hoe AI-beelden de herkenning van huidkanker kunnen verbeteren
Nederland hoort bij de landen met het hoogste aantal nieuwe gevallen van melanomen (kwaadaardige huidkanker) van alle landen in de EU. België staat helaas ook hoog op de lijst. Ook heeft Nederland een bovengemiddeld hoge sterfte aan huidkanker in vergelijking met andere EU-landen. AI-ondersteunde tools zouden in de toekomst kunnen helpen om de kans op een juiste diagnose te vergroten.
Maar AI-modellen zijn bevooroordeeld, ook de modellen die de ruggengraat vormen van intelligente diagnostische tools in de dermatologie. Ze herkennen huidkanker bij sommige bevolkingsgroepen, zoals mensen met een donkerder huidtype of jonge mensen, duidelijk slechter, omdat die groepen in de trainingsbeelden simpelweg te weinig voorkomen.
Daar richt een project van het German Research Center for Artificial Intelligence (DFKI) zich op. Het team rond Stanislav Frolov ontwikkelde een generatief AI-model dat fotorealistische beelden van huidkanker maakt. Die beelden moeten medische herkenningsmodellen eerlijker maken.
In dit interview legt Frolov uit waarom AI-modellen bias hebben en hoe kunstmatig gegenereerde huidkankerbeelden kunnen helpen om vertekeningen in de dermatologie te compenseren.
AI-modellen zijn bevooroordeeld; dat noemen we bias. Kunnen AI-modellen ooit vrij van bias zijn? Ligt dat aan de grote bedrijven die de AI-ontwikkeling in belangrijke mate beïnvloeden?
Waarschijnlijk niet. Een AI leert van data, dus van een uitsnede van de wereld die mensen verzamelen en selecteren. Die trainingsdata zijn als een spiegel: alles wat onze samenleving vormt, goed of fout, komt uiteindelijk terug in de informatie waarmee we de AI trainen. Zelfs als geen enkel groot concern een AI zou controleren, moet iemand beslissen welke data worden verzameld en voor de training worden gebruikt. In dat selectieproces spelen altijd waardeoordelen en culturele en persoonlijke keuzes mee.
De bias van een AI volledig wegnemen kan dus geen realistisch doel zijn. Je moet zichtbaar maken welke bias er is, hoe je die kunt meten en wat je eraan kunt doen.
Welke technische mogelijkheden zijn er om bias te verminderen?
Eenvoudig gezegd zijn er drie aangrijpingspunten. Het eerste is de training van het AI-model. Je kunt er bijvoorbeeld op letten dat je zo evenwichtig mogelijke data gebruikt. Of je genereert kunstmatige data voor ontbrekende groepen en voegt die aan de trainingsdatasets toe. Dat levert aanzienlijk eerlijkere AI-modellen op.
Het tweede aangrijpingspunt is het leerproces zelf. Tijdens de training van de modellen kun je al regels voor fairness inbouwen. Het derde aangrijpingspunt komt na de training. Als een model klaar is met trainen, kun je testen hoe het zich bij verschillende groepen gedraagt. Stel je daarbij bias vast, dan kun je met finetuning bijsturen.
Hoe ziet zo’n finetuning eruit?
Finetuning is ook een vorm van training, alleen niet meer op een grote, diverse dataset, maar voor specifiekere taken. Je verzamelt gericht data voor de gevallen waarin het voorgetrainde model slechter presteert.
Je werkt als onderzoeker aan een onderzoeksproject van het German Research Center for Artificial Intelligence (DFKI). Binnen het project MedGenAI hebben jullie een speciaal generatief AI-model ontwikkeld dat synthetische beelden van huidziekten kan maken. Met die beelden moet de bias van AI-diagnosetools in de dermatologie worden verminderd. Welke uitgangssituatie wilden jullie verbeteren?
Binnen MedGenAI hebben we ons beziggehouden met huidkanker, vooral met het melanoom als gevaarlijkste vorm. De genezingskansen bij melanomen zijn zeer goed als ze vroeg worden ontdekt. En daarbij kunnen AI-tools helpen.
De trainingsdata voor AI-diagnosetools voor huidkankerherkenning zijn echter ongelijk verdeeld. Hetzelfde geldt voor de testdata: donkerder huidtypen en jongere mensen komen daarin veel minder vaak voor. Dat heeft twee gevolgen. Ten eerste werkt de AI voor die groepen waarschijnlijk slechter. Ten tweede (en dat weegt misschien zwaarder) kun je de fairness van het model niet volledig toetsen, omdat testbeelden voor de ondervertegenwoordigde groepen ontbreken.
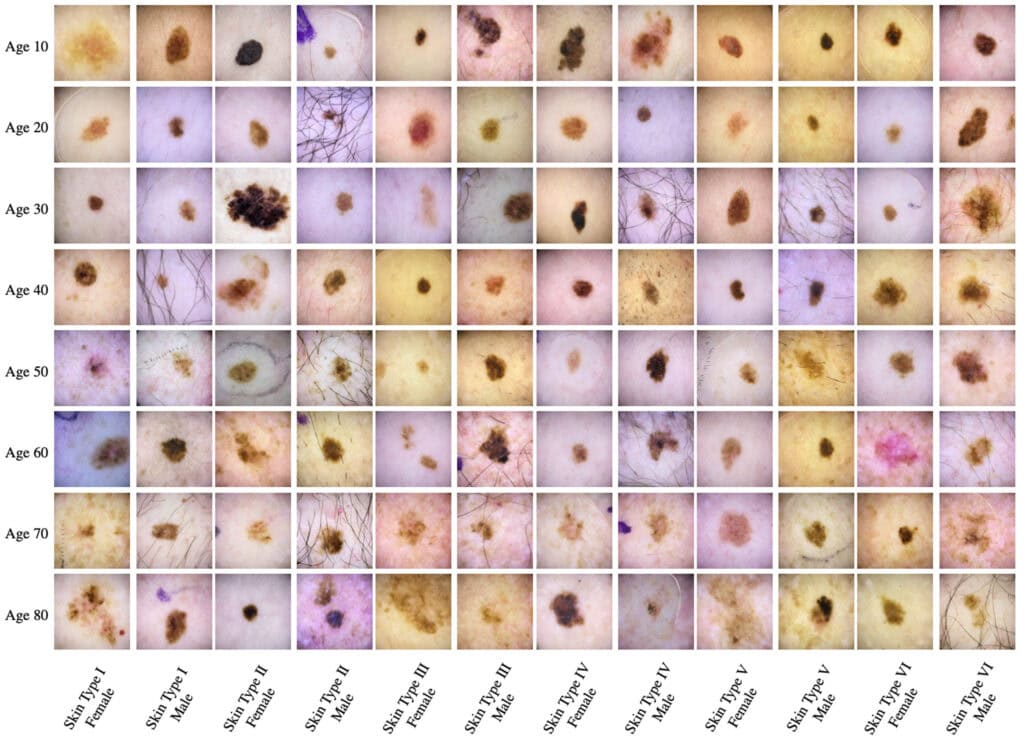
Ons idee was daarom een generatief AI-model te ontwikkelen dat gericht synthetische huidkankerbeelden maakt. Het moest bestuurbaar zijn via parameters als geslacht, leeftijd, huidtype of willekeurige combinaties daarvan. Met het voltooide model kunnen we nu beelden maken voor testgroepen die in werkelijkheid zelden voorkomen. Die testdata helpen ons herkenningsmodellen nauwkeuriger te analyseren.
Je kunt de bias van een AI-model dus met synthetische data verminderen. Die data kunnen zelf door AI zijn gegenereerd. Hoe zorg je ervoor dat ze geen hallucinaties bevatten?
Die zorg is terecht. Een AI-model dat op vertekende data heeft geleerd, geeft die fouten door. Als de volgende modelgeneratie met de output van eerdere modellen wordt getraind, reproduceert het nieuwe model de bias vaak nog sterker.
Er zijn echter ook interessante gevallen waarin precies het omgekeerde gebeurt. Aan het begin van generatieve beeldsynthese werden menselijke gezichten bijvoorbeeld nog erg slecht weergegeven. De vele details waarop wij mensen heel gevoelig reageren, konden generatieve beeldmodellen toen nog niet goed reproduceren.
Wanneer zulke synthetische beelden in de training werden gebruikt, bleek de volgende generatie AI-modellen juist minder genderbias te vertonen, juist doordat de synthetische data zulke onscherpe gezichten opleverden.
Dat is interessant, maar nog even terug naar de vraag: kun je garanderen dat door AI gegenereerde trainingsdata geen onjuiste informatie bevatten?
Dat is lastig. Kwaliteitscontroles moeten op meerdere niveaus aangrijpen. Ten eerste moet je controleren hoe dicht de kunstmatige data bij echte data liggen. Ten tweede kun je zogeheten controlemodellen gebruiken. Dat zijn AI-modellen die onafhankelijk van het eigenlijke model zijn getraind en onrealistische trainingsdata uitfilteren.
Ten derde moet je vakinhoudelijke expertise inschakelen. Die blijft onmisbaar wanneer je AI-modellen in de geneeskunde gebruikt. Dermatologen moeten de door AI gegenereerde beelden beoordelen en vaststellen of ze klinisch plausibel zijn.
Hoe weet je dat een door jullie AI-model gegenereerd beeld van een huidziekte werkelijk overeenkomt met het echte ziektebeeld en niet gehallucineerd is?
Voor één afzonderlijk beeld kun je dat nooit voor honderd procent garanderen. Je kunt de resultaten wel systematisch borgen, en dat hebben we in ons project ook gedaan.
In de testfase hebben we drie voorgetrainde herkenningsmodellen gebruikt en die onze kunstmatige beelden voorgelegd. Daarbij bleek dat de modellen op de synthetische beelden ongeveer hetzelfde reageren als op echte beelden.
De belangrijkste kenmerken voor het herkennen van de ziekte waren dus aanwezig. Idealiter schakel je natuurlijk vakexperts in, dus dermatologen die bij de training en de selectie van de juiste data helpen. Dat is echter erg tijdrovend en duur.
Het gaat er dus eerder om dat de grote massa synthetische beelden foutvrij is?
Precies. Bepalend is hoe een herkenningsmodel zich gemiddeld gedraagt, dus of het gemiddelde synthetische beeld binnen de verdeling van de echte beelden valt.
Zijn synthetische data even geschikt om bias te verminderen bij taal-, beeld- en audiomodellen? Welke modeltypen profiteren er meer of minder van?
Overal waar bias ontstaat doordat een groep in de data ontbreekt of ondervertegenwoordigd is, kun je met synthetische data bijsturen – ook bij audio of tekst. Het makkelijkst gaat dat bij beelden, omdat je die eenvoudiger kunt controleren.
Bij spraaksynthesemodellen werkt het ook behoorlijk goed om met synthetische data tegen te sturen. Zo kun je bijvoorbeeld zeldzame talen en dialecten beter representeren.
Er worden ook kunstmatig gegenereerde teksten gebruikt om grote taalmodellen te trainen. De bias van tekstuitvoer is echter moeilijker te vatten, omdat die in stereotypen en denkpatronen zit en minder in de grammatica of syntaxis van teksten.
Jullie generatieve beeldmodel kan ook zogeheten counterfactuals maken. Wat is een counterfactual?
Een counterfactual is in feite een ‘wat-als’-vraag: wat als één aspect van een beeld verandert en al het andere hetzelfde blijft? Een voorbeeld: ik heb een melanoom op een bepaalde plek op de huid en genereer dat beeld eenmaal bij een lichter en eenmaal bij een donkerder huidtype.
Medisch gezien blijft de ziekte zelf dezelfde; alleen de huidskleur verandert. Hoe gedraagt het herkenningsmodel zich dan? Geeft het nog steeds dezelfde diagnose en met dezelfde zekerheid? Wordt het onzekerder? Of geeft het zelfs een andere diagnose?
Als een model bij een donkere huid slechter presteert, is in eerste instantie onduidelijk waarom. Het kan aan de ziekte liggen, maar misschien hebben de beelden ook een andere kwaliteit of zijn ze met een andere camera of onder andere lichtomstandigheden gemaakt. Met counterfactuals kun je analyseren voor welke aspecten van een beeld een AI-model gevoelig is en voor welke minder.
Betekent dat dat counterfactuals de foutgevoeligheid van dermatologische herkenningsmodellen kunnen verminderen?
Allereerst kun je de foutgevoeligheid meetbaar maken. Met counterfactuals ontdek je voor welke aspecten of vormen van bias een AI-model bijzonder gevoelig is. In een tweede stap gebruik je de inzichten uit die analyse om bijvoorbeeld gericht synthetische data te maken, echte trainingsdata beter te filteren of het model bij te sturen, bijvoorbeeld via de lossfunctie (die kijkt hoe ver de voorspellingen naast de werkelijkheid zitten).
Kun je dat nog eens duidelijk uitleggen?
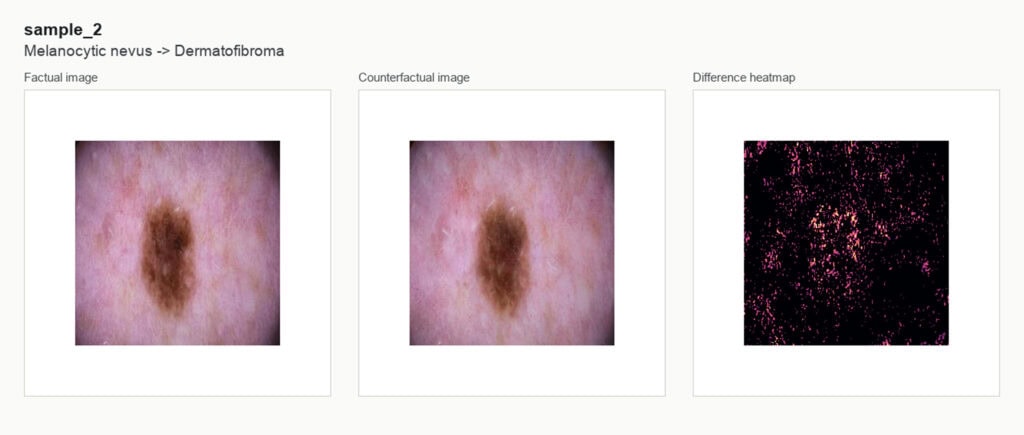
Stel dat we een foto van een melanoom hebben (dat mag een echte foto zijn) en een voorgetraind herkenningsmodel. Het herkenningsmodel levert voor het beeld een waarschijnlijkheidsverdeling voor mogelijke diagnoses.
Vervolgens voeg je een generatief beeldmodel aan het proces toe: dat gebruikt het signaal van het herkenningsmodel om het beeld licht te veranderen, zodat een andere diagnose ontstaat.
Aan het eind heb je twee beelden: het origineel met de eerste diagnose en het licht gewijzigde synthetische beeld met een nieuwe diagnose. Uit het verschil, dus hoeveel het beeld moest worden veranderd voordat de diagnose omslaat, kun je afleiden welke kenmerken voor het herkenningsmodel doorslaggevend zijn.
Hoe zouden de inzichten uit jullie onderzoeksproject in de toekomst kunnen doorwerken in medische diagnosetools?
Ten eerste zou het door ons ontwikkelde generatieve beeldmodel het testproces van dermatologische herkenningsmodellen kunnen ondersteunen. Voordat een AI-ondersteunde medische diagnosetool op de markt komt, test je die met zo evenwichtig mogelijke testgroepen.
Daarvoor heb je in de eerste plaats echte data nodig, maar liefst ook synthetische. Zo kun je zo veel mogelijk combinaties van geslacht, leeftijd en huidtype afdekken.
Ten tweede kun je met synthetische data gaten in de trainingsdata van medische herkenningsmodellen dichten en vanaf het begin eerlijkere, robuustere modellen ontwikkelen. En ten derde laten counterfactuals zien welke kenmerken een AI-model gebruikt voor oneerlijke voorspellingen.
Voordat een AI-diagnosetool in de kliniek wordt ingezet, blijven onderzoeken met echte patiënten echter onmisbaar. Experts moeten de beelden en voorspellingen beoordelen om er zeker van te zijn dat het model voor een diagnose de juiste kenmerken gebruikt. Alleen zo ontstaat betrouwbare AI in de geneeskunde.
Robin Ahrens en Alieke van Sommeren
Links bij dit artikel
MedGenAI
Towards Facilitated Fairness Assessment of AI-based Skin Lesion Classifiers Through GenAI-based Image Synthesis
Generating Counterfactual Trajectories with Latent Diffusion Models for Concept Discovery
Praat mee