De bijna onverzadigbare honger naar rekenkracht van AI overbelast afzonderlijke chips en dwingt tot taakverdeling. We hebben een kwartet van vier Intel Arc Pro B70’s getest.
Van AI-pc naar lokaal AI-workstation
AI-toepassingen slokken enorme hoeveelheden rekenkracht op en nemen hele datacenters in beslag – tot zover niets nieuws. Maar dat geldt niet alleen voor het trainen en het verwerken van talloze gelijktijdige verzoeken via de cloud, maar ook voor lokale AI.
De wens om AI-servers in je eigen installaties en in een afgeschermd netwerk te draaien, kan allerlei redenen hebben, variërend van wantrouwen tegenover (Amerikaanse) cloudproviders tot beter bereken- en beheersbare kosten en het beschermen van gevoelige klant- en bedrijfsgegevens.
Juist kleine en middelgrote bedrijven, maar ook ambitieuze particuliere gebruikers, willen de volgende schaalvergroting na de eerste AI-stappen daarom vaak lokaal houden en zo onder controle houden.
Na de simpele pc met een grafische kaart met veel geheugen is de volgende stap aan de beurt. Dat zou een workstation kunnen zijn met meerdere grafische kaarten en veel geheugen om grotere taalmodellen te draaien, of om de verzoeken van meerdere gebruikers of afdelingen te verwerken.
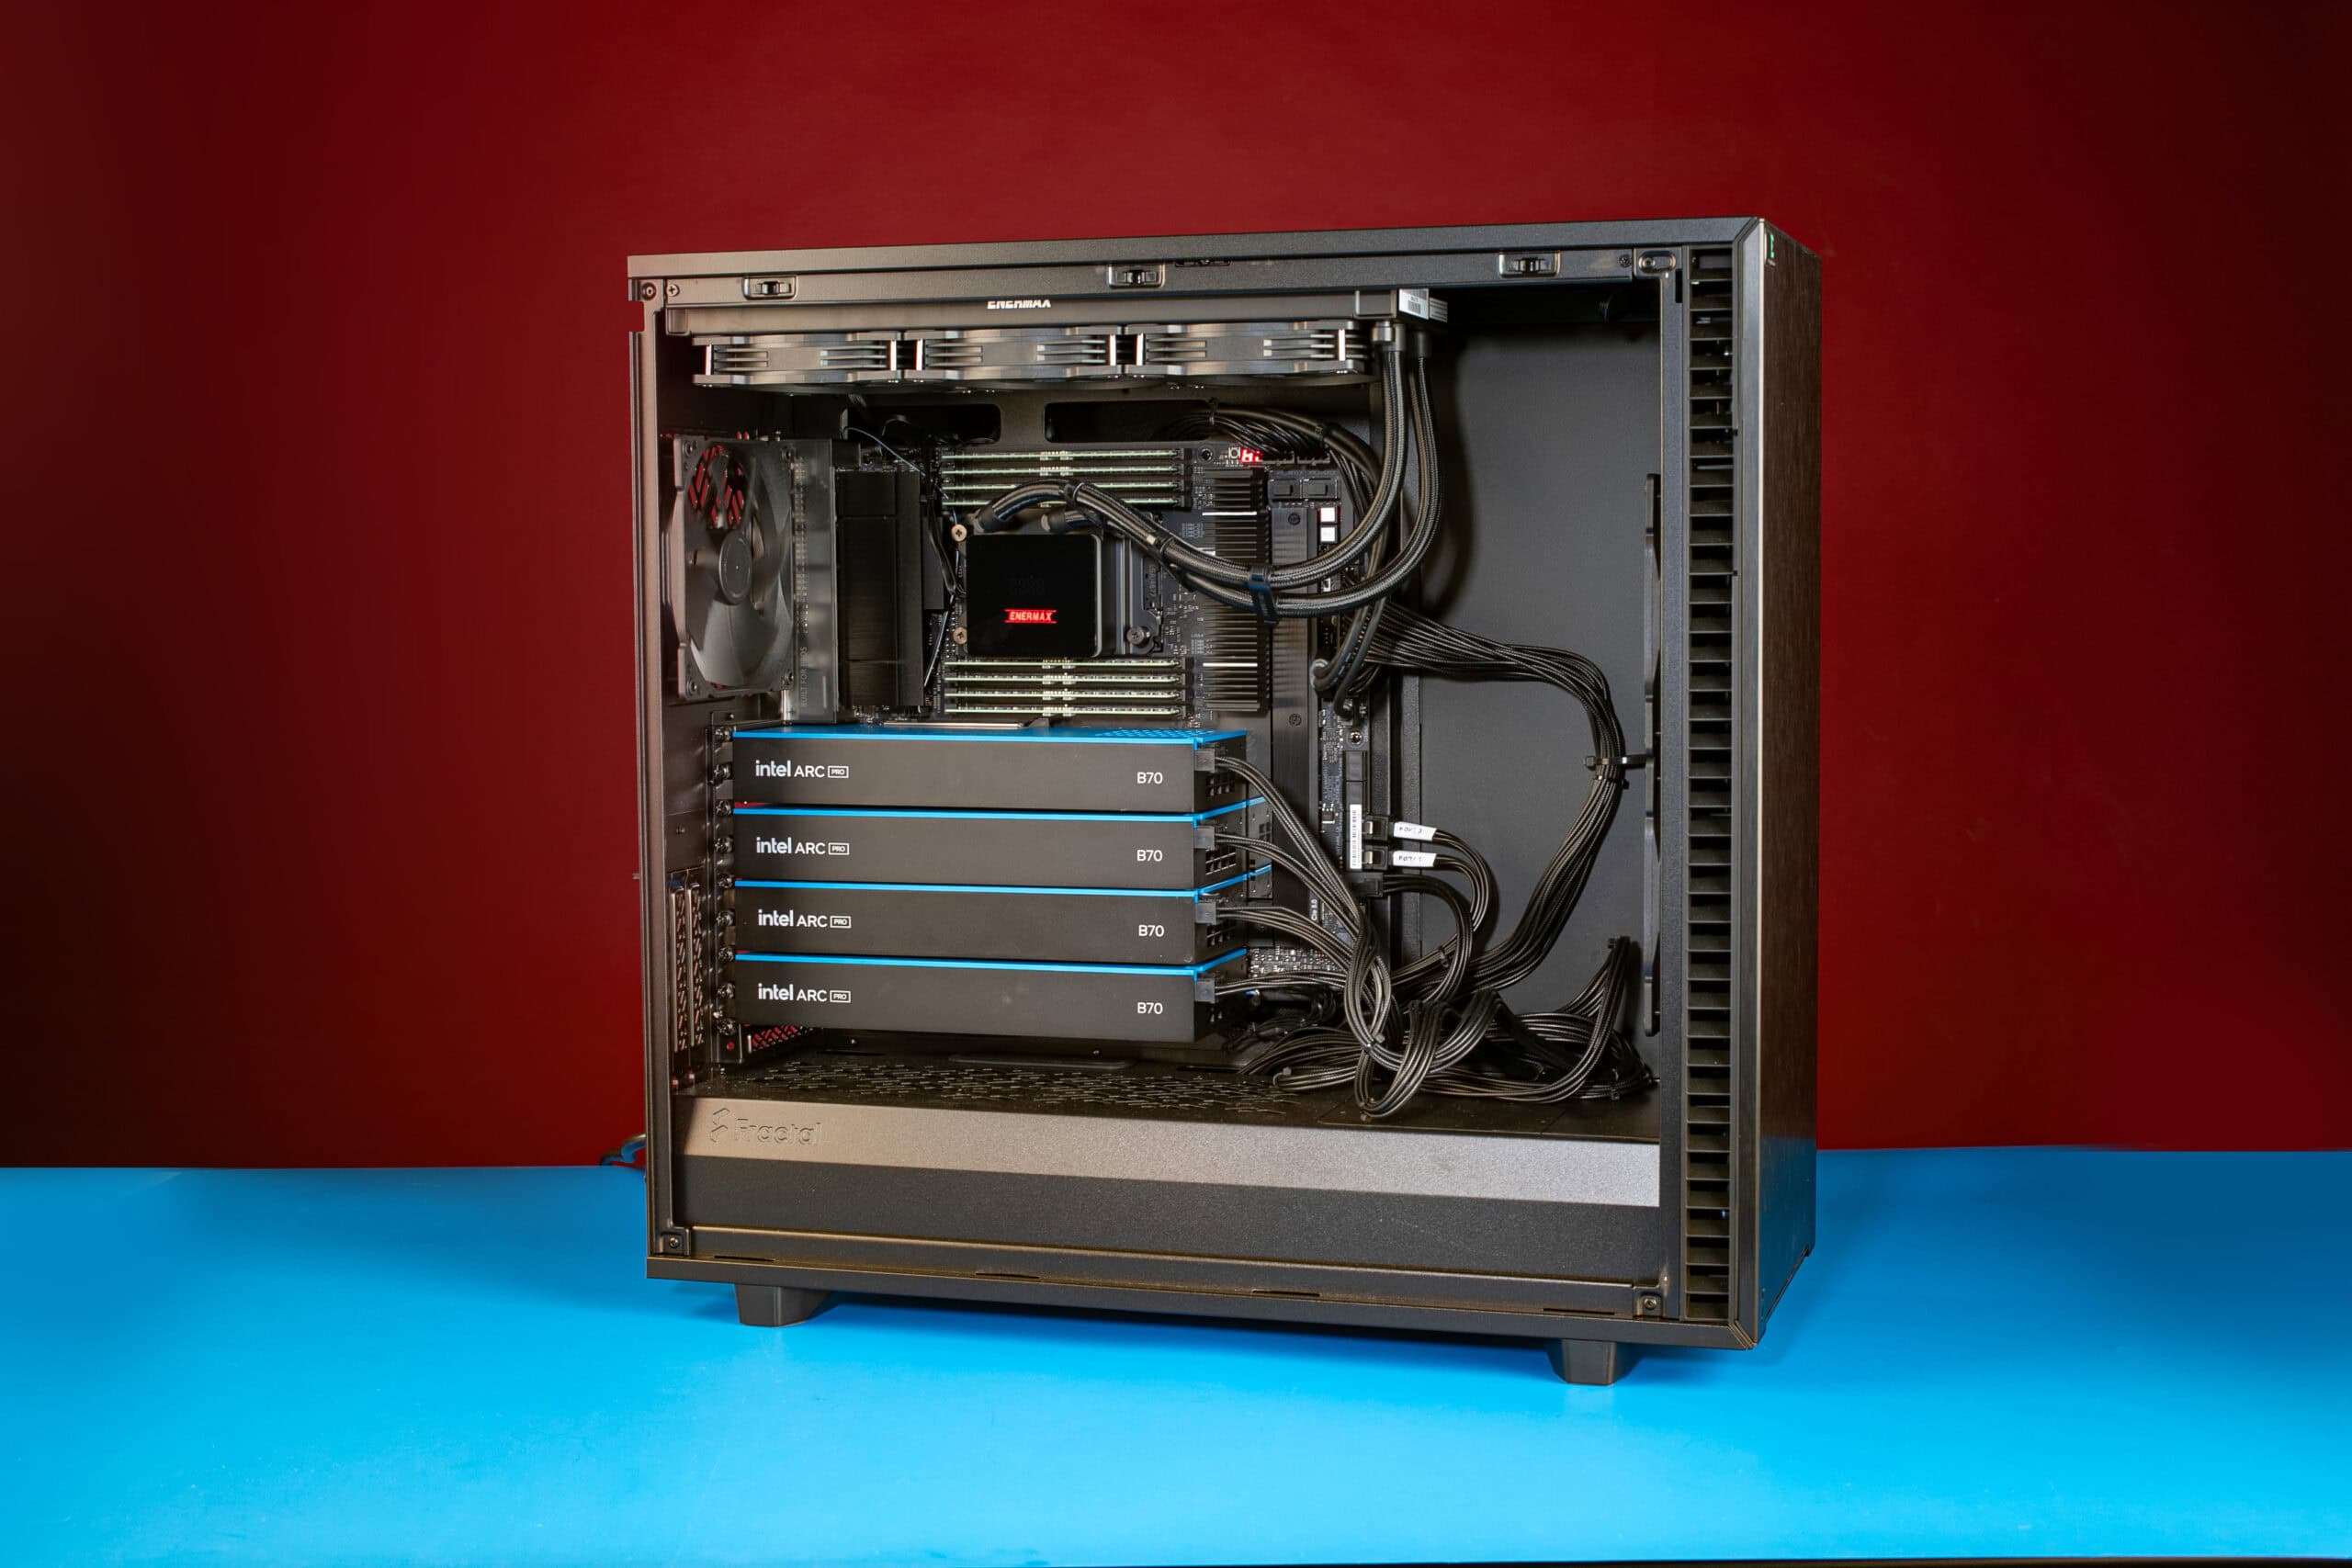
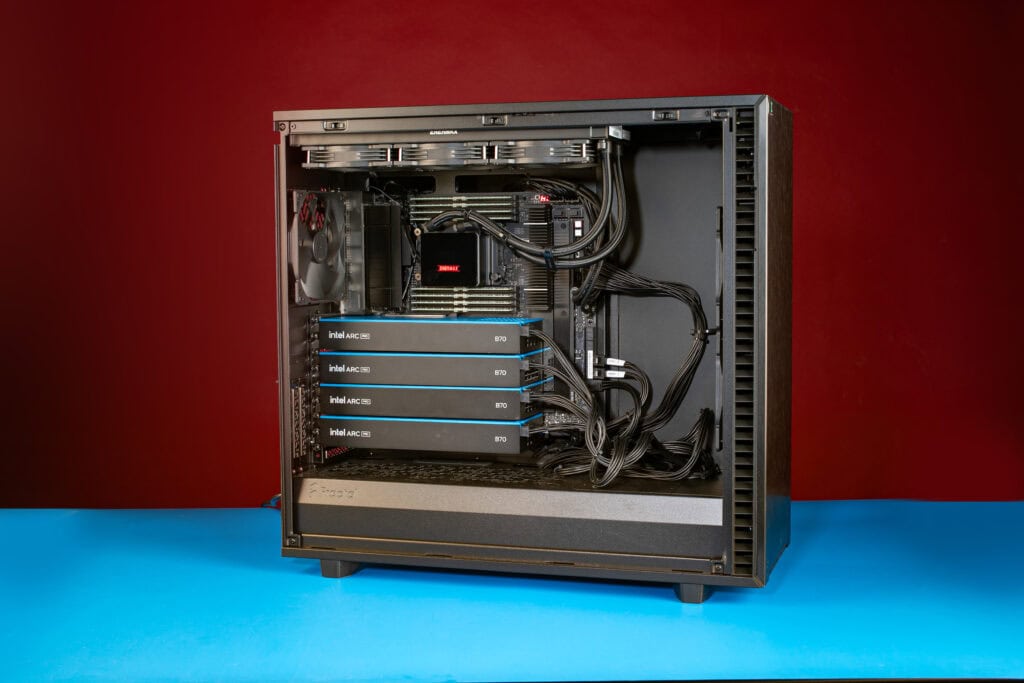
Daar is een zo goedkoop mogelijke grafische kaart met veel geheugen geschikt voor, zoals de Intel Arc Pro B70, die we ook al apart hebben getest [1]. Vier van die kaarten met elk 32 GB zitten in ons workstation, dat zelf ook nog eens 256 GB RAM heeft en waarvan de onderdelen in totaal zo’n 17.000 euro kosten.
We hebben daarmee een aantal AI-toepassingen onder Windows en Linux uitgeprobeerd.
Workstation-uitrusting
Oorspronkelijk had Intel bij Project Battlematrix AI-workstations in het vooruitzicht gesteld met maximaal acht Arc Pro-grafische kaarten. Wat daar nu van overblijft is echter niet meer dan de helft van de matrix.
Inmiddels probeert Intel AI-workstation-pc’s de voorgrond te zetten met slechts vier, maar dan wel des te krachtigere grafische chips voor AI-inferencing. De architectuur zou nog steeds schaalbaar moeten zijn tot acht GPU’s. Daarvoor zijn echter slots voor serverracks nodig, want acht dualslot-versnellers passen zelfs niet in grote workstationbehuizingen.
Zo kregen we na lang wachten een workstationsysteem in handen op basis van de al wat verouderde Intel Xeon-processor w5-3435X uit het Sapphire Rapids Refresh-programma (zie link bij dit artikel). De processor heeft 16 (P-)kernen met HyperThreading en gaat in de turbomodus tot 4,7 GHz. Bovendien heeft Intel hem in het testsysteem voorzien van vloeistofkoeling met een 360-radiator.
Hij wordt ondersteund door 256 GB aan geheugen, verdeeld over acht modules van het type DDR5-4800R, dus registered-DIMM’s zoals in workstations gebruikelijk.
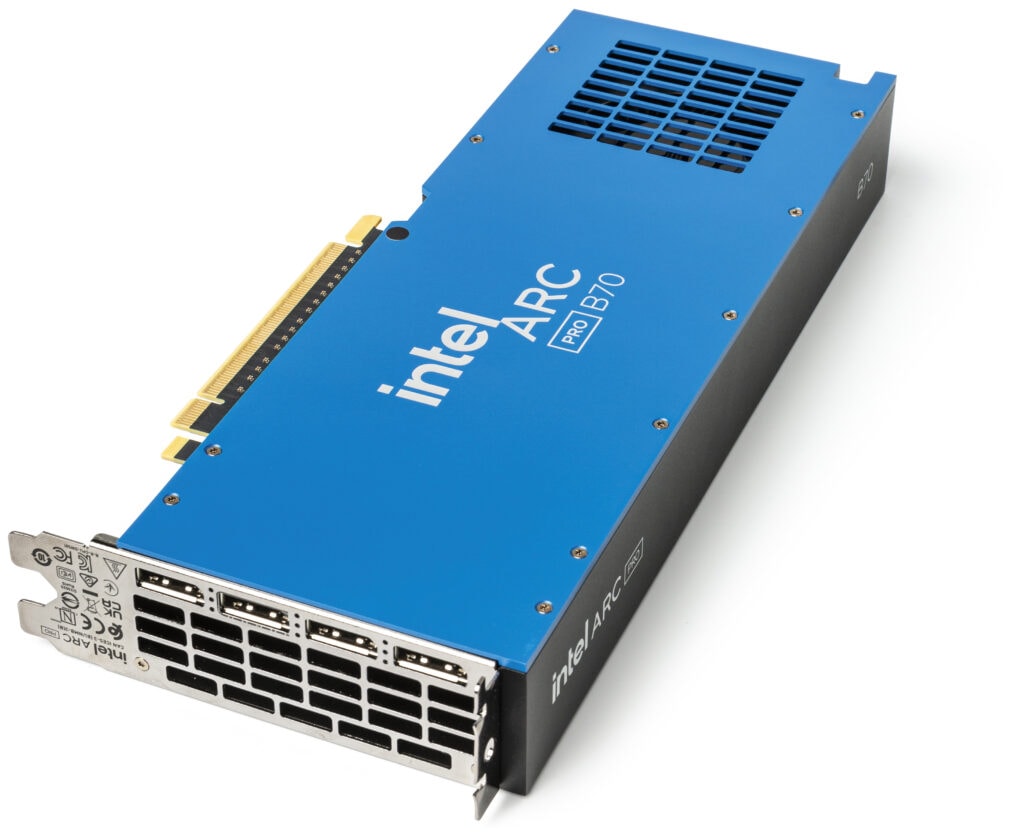
Maar die basis speelt slechts een bijrol en is vooral bedoeld om voldoende PCIe 5.0-lanes beschikbaar te stellen voor de vier Arc Pro B70 grafische kaarten. Die laatste komen uit Intels eigen productlijn, het zijn zogeheten Intel Branded Cards (IBC).
Ze zijn geoptimaliseerd voor gebruik in workstations en hebben een standaardbehuizing van 26,7 centimeter lang en 4 centimeter breed. Hun radiale ventilator met een diameter van 70 millimeter kan dankzij de korte printplaat zowel van boven als van onder lucht aanzuigen, zodat zelfs vier kaarten die dicht op elkaar in een rij zijn geplaatst geen risico lopen op oververhitting.
Daarbij helpt ook de relatief lage Thermal Design Power van 230 watt – partnerkaarten zoals de Asrock Arc Pro B70 Creator [1] gaan tot wel 290 watt.
Intel grijpt de TDP aan om, nogal optimistisch, slechts één achtpolige stroomstekker per kaart te voorzien. Maar als de B70 zijn TDP ook maar een beetje benut, gebruikt hij al 5 watt meer dan er nominaal via de PCIe-aansluiting (75 watt) en de achtpolige kabel (150 watt) mag stromen.
Al met de 3D-game Cyberpunk 2077 verbruikte de kaart continu 234 watt en bij 3DMark zelfs 245 watt. Beide waarden liggen duidelijk boven de specificaties – niet alleen van de kaart, maar ook van de beoogde stroomvoorziening. Intel heeft ons daar verder geen commentaar op gegeven.
Tijdens de tests hebben we verder geen instabiliteiten waargenomen, hoewel sommige AI-toepassingen de kaarten tijdens onze tests net zo zwaar belastten als games of speciale stresstests.

Energieverbruik en geluidsniveau
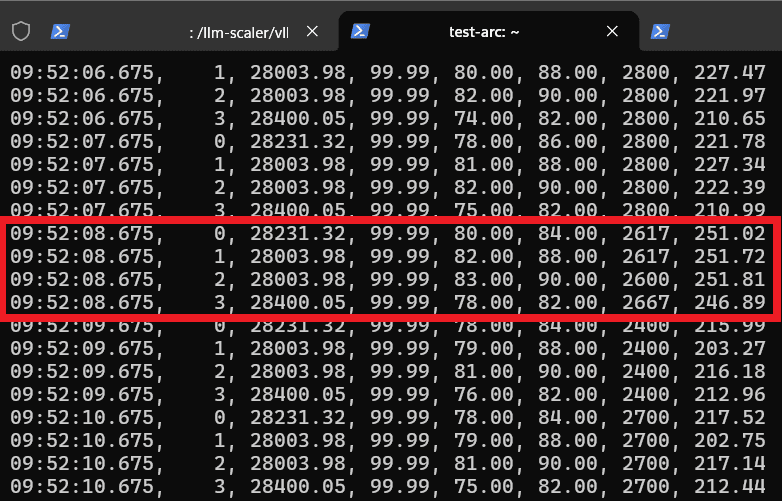
Idle verbruikte het systeem, ondanks het handmatig aanpassen van de PCI-Express-energiebesparingsinstellingen naar maximaal – zoals algemeen aanbevolen voor Intel-grafische kaarten – nog steeds maar liefst 226 watt. Dat komt vooral door het nog steeds te hoge idle energieverbruik van de Arc-kaarten, die zelfs zonder aangesloten monitor elk ruim boven de 30 watt verbruiken.
Maar ook het workstationplatform zelf, inclusief al zijn extra energievreters zoals de chip voor onderhoud op afstand, dual-10G-ethernet, 72 actieve PCIe 5.0-lanes en acht geheugenmodules, is daar niet helemaal onschuldig aan.
Als je zo’n systeem aanschaft voor productief gebruik, zul je het echter waarschijnlijk eerder volledig benutten en eventueel na sluitingstijd uitschakelen in plaats van het langdurig maar zuinig in een ruststand te laten draaien.
De ventilatoren hadden duidelijk moeite met de algehele hoge warmteafgifte van het systeem. Zelfs in ruststand maten we in onze geluidsarme kamer 0,6 sone.
De vier workstationkaarten, die zoals gewoonlijk – naast de ventilatoren van de CPU-vloeistofkoeling en de behuizingsventilatoren – ook idle niet stilstonden, droegen daaraan bij.
Onder volledige belasting verbruikte het systeem gemiddeld tot 1325 watt en verwarmde het onze geluidsmeetkamer merkbaar. De ventilatoren draaiden daarbij op volle toeren en veroorzaakten een mini-orkaan van 6,8 sone om de elektronische onderdelen tegen oververhitting te beschermen.
Bij gedeeltelijke belasting van zo’n 550 watt (en slechts één GPU op volle kracht) was het geluid met 2,5 sone aanzienlijk draaglijker, maar nog steeds luid. De sterke neiging tot piepende spoelen werd toen echter niet meer gemaskeerd door een akoestische ruisdeken.
Als je de mogelijkheid hebt, moet je zo’n workstation in een aparte en indien mogelijk goed gekoelde ruimte gebruiken.
Pre-order: De gevolgen van Artificiële Intelligentie
- Wat AI betekent voor werk en maatschappij
- AI in de praktijk: van cybercrime tot beeld
- Nieuwste AI: van browsers tot taalmodellen
Lees c’t nu tijdelijk al vanaf 5,99 per maand
- Onbeperkt toegang tot ct.nl
- Nieuwsbrieven over AI, security & netwerken
- Eenvoudig op te zeggen
Kwestie van proberen
We namen het Intel-systeem bij wijze van proef onder Windows 11 Pro in gebruik. Niet alleen weigerden de meeste bekende AI-benchmarks, zoals UL Procyon AI en MLPerf Client, om de werkbelasting zinvol over de vier grafische kaarten te verdelen, maar ook bij afzonderlijk gebruik was de Arc Pro B70, net als bij de test van het Asrock-model, soms ongewoon traag – zelfs langzamer dan de kleine gamingvariant, de Arc B580.
Intel kon ons daar bij navraag geen verklaring voor geven. Aan de andere kant heeft Intel ook niet aangevoerd dat het hier om een specifiek probleem ging.
Maar daar bleef het niet bij: het stuurprogramma-infovenster op de taakbalk waarschuwde ons op onvoorspelbare wijze dat deze of gene van de vier Arc Pro B70’s af en toe niet in de PCIe 5.0-modus draaide, alleen zonder resizableBAR werkte of helemaal geen PCI Express ondersteunde (wat het daarmee ook bedoelde).
Wat het nog lastiger maakte, was dat na elke herstart de fouten anders over de kaarten verdeeld werden. Soms was slechts één van de vier kaarten ‘defect’, soms werkte er maar één zoals het hoorde.
Ook bij afzonderlijk gebruik kwam een van de genoemde fouten vaak voor. Een door het stuurprogramma aangeboden poging om het probleem op te lossen via een koude start leverde geen betrouwbare verbetering op.
Een praktijktest van de overdrachtssnelheid liet bovendien zien dat zelfs de kaarten waarvan de driver alleen PCIe 4.0 bevestigde, toch met de 5.0-snelheid van meer dan 50 GB per seconde aangestuurd werden. Met PCIe 4.0 is bruto maximaal 32 GB/s mogelijk.
We zijn daarom momenteel geneigd om dat af te doen als een vals alarm van het stuurprogramma.
De eerder genoemde Asrock-kaart met Arc Pro B70 vertoonde dat gedrag niet in het Intel-systeem, maar de Intel-kaarten wel. Toch slaagden sommige programma’s erin om de kaarten als één geheel aan te spreken, of beter gezegd, het werk zinvol over ze te verdelen.
Het 3D-renderprogramma Blender was er daar één van. In vergelijking met één kaart rekende het programma onze meest veeleisende testscène Lone Monk in ongeveer een derde van de tijd – om precies te zijn in 85 in plaats van 253 seconden.
Helaas liep de berekening van die scène vast toen we de raytracing-hardware van de Arc Pro B70 met Intels optioneel in te schakelen Embree-on-GPU-uitbreiding in Blender activeerden. Dat verkortte de rekentijd op een enkele Arc Pro B70-GPU – daar werkte het namelijk wel – met bijna een kwart tot 193 seconden.
In vergelijking daarmee was het B70-kwartet zonder Embree nog maar ongeveer 2,3 keer zo snel als de enkele kaart met Embree.
AI onder Windows
Als er geen AI-benchmarks willen werken, dan misschien toch echte AI-toepassingen? We hebben dat uitgeprobeerd aan de hand van LMStudio. De interface van dat programma integreert desgewenst een groot aantal grote taalmodellen, die voor lokaal gebruik gedownload worden.
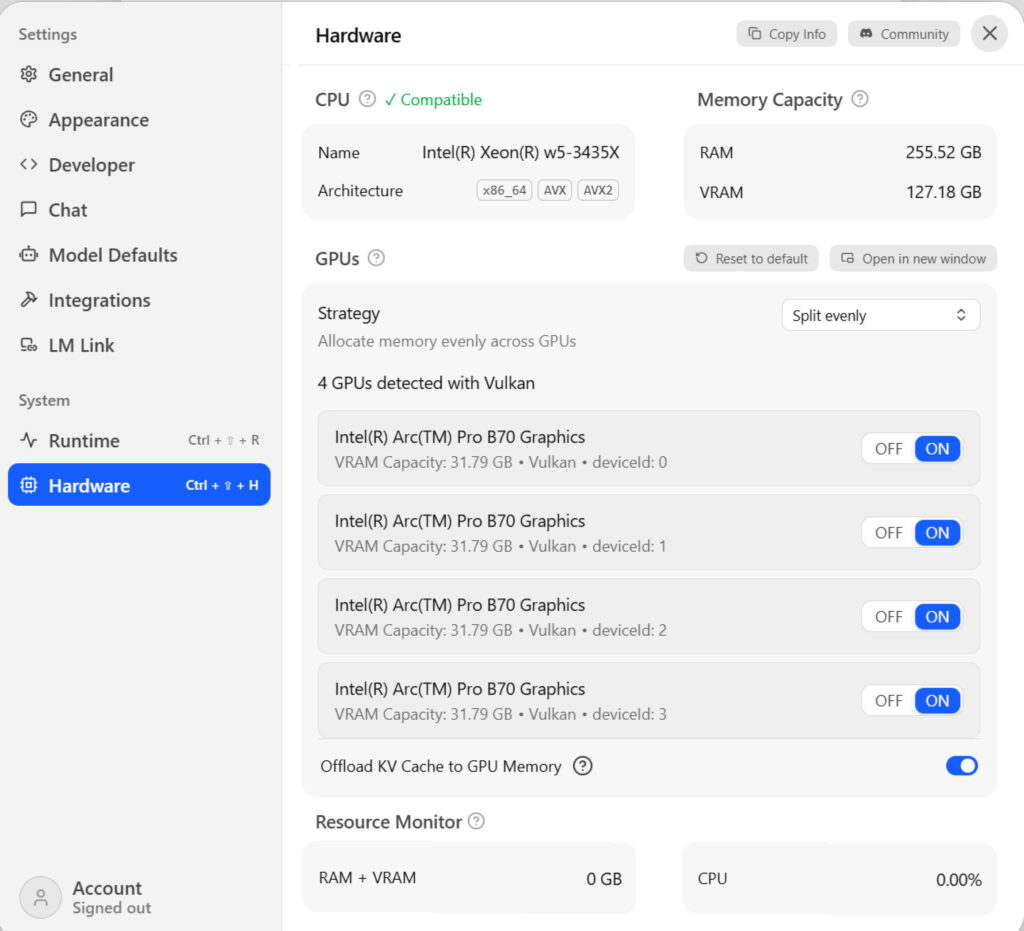
LMStudio stuurt de AI-modellen aan via de softwarebibliotheek llama.cpp en het Vulkan-back-end. Met de toetsencombinatie Ctrl+Shift+H ga je in de interface direct naar de instellingen, waar je ook afzonderlijke GPU’s kunt in- of uitschakelen en bovendien kunt kiezen over welke GPU’s de LLM’s moeten worden verdeeld.
Als de prestaties om onverklaarbare redenen tegenvallen, kan het trouwens handig zijn om daar even te kijken of er misschien een geïntegreerde grafische kaart meerekent, waardoor de dure GPU afgeremd wordt.
We hebben een aantal LLM’s bekeken die vanwege hun omvang niet in aanmerking zouden komen voor gebruik in een gewone pc met slechts één grafische kaart, aangezien 32 GB dan de bovengrens vormt – in elk geval in de (zeer ruim opgevatte) mainstream-markt. En kaarten met 48 GB kosten al snel twee keer zoveel als een Arc Pro B70 of – in het geval van Nvidia’s RTX Pro 6000 Blackwell – meer dan alle vier de Arc Pro’s bij elkaar.
We zijn echter begonnen met een piepklein model van Google. Gemma 4 E4B-it heeft ongeveer 6 GB grafisch geheugen nodig. Het draaide ook op een pc met een GeForce RTX 5080 met een schijnbaar snelle 168 tokens per seconde (t/s) en op een Nvidia RTX 4000 SFF Ada met 65 t/s. Beide kaarten kunnen het volledige LLM in hun geheugen kwijt, wat cruciaal is voor de uitvoersnelheid.
Het Arc Pro B70-kwartet kan daar natuurlijk nog niet mee uitblinken, omdat de hogere administratieve last door de verdeling een mogelijke prestatiewinst door de extra middelen weer tenietdoet: een enkele Arc Pro B70 leverde meer dan 60 t/s.
Het al iets grotere Qwen3-Next-80B-A3B-Instruct uit de LLM-familie van de Chinese aanbieder Alibaba Cloud is een Mixture-of-Experts-model. Het redt het met slechts 3 miljard tegelijkertijd actieve gewichten van in totaal 80 miljard beschikbare, maar past toch niet meer in het lokale geheugen van de meeste grafische kaarten.
Het Intel-kwartet verdeelde het model in stukjes van elk 14 tot 17 GB en haalde meteen 51 tokens per seconde. Daarbij worden de gebruikte Arc Pro B70-chips echter maar voor een klein deel benut, namelijk met zo’n elf tot twaalf procent.
Een GeForce RTX 5080 bleef met 20 t/s ver achter, net als de dure RTX 6000 Ada met haar 48 GB grafisch geheugen. Die was door LMStudio wat vreemd, maar wel reproduceerbaar geconfigureerd en werd maar voor zo’n 33 van de 48 GB benut, waardoor een groot deel van de LLM-lagen alsnog op de CPU draaide. Met wat handmatig bijwerken konden we de RTX 6000 Ada opvoeren tot meer dan 80 t/s, waardoor hij toen sneller draaide dan het Intel-kwartet.
Echt grote LLM’s
Het ligt anders bij omvangrijkere modellen zoals OpenAI’s GPT-OSS-120B. Met een Radeon RX 9070 XT haalden we maximaal zo’n 15 tokens per seconde.
GPT-OSS-120B gebruikt 5,1 miljard actieve parameters en vier actieve experts per token. Dankzij MXFP4-kwantisering is er echter geen 120, maar ‘slechts’ zo’n 63 GB opslagruimte nodig. Dat is echter nog steeds te veel, zowel voor onze gamingkaarten als voor de Nvidia RTX 6000 Ada, die met een GPU-offload van 19 van de 36 lagen moeizaam 20 tokens per seconde haalde.
Zelfs met de best mogelijke GPU-offload van 26 lagen haalden we op de RTX 6000 Ada slechts zo’n 30 t/s. Een GeForce RTX 5080 was maar half zo snel.
De vier Arc Pro B70’s lieten de RTX 6000 Ada ver achter zich met een doorvoersnelheid van zo’n 51 t/s in GPT-OSS-120B. Daarvoor verdeelden ze de geheugenbelasting onderling in stukjes van 14 tot 17 GB. Rekenkracht, bijvoorbeeld voor extra verzoeken van andere gebruikers, zou nog ruimschoots beschikbaar zijn geweest. De bezettingsgraad bleef steeds onder de 15 procent hangen, wat ook duidelijk werd uit het energieverbruik van minder dan 70 watt per GPU.
Als klap op de vuurpijl hebben we Qwen3-235B-A22B-2507 getest. Ook dat is een Mixture-of-Experts-model. Het activeert 22 miljard parameters van 128 experts, waarvan er op elk moment acht actief zijn. Daarvoor wil het volgens LMStudio graag zo’n 110 GB geheugen in 96 lagen in beslag nemen.
Als je het op de CPU rekent, levert het LLM 7,28 tokens/s. Met de ondersteuning van de vier Arc Pro B70’s kun je dat versnellen tot het dubbele, zo’n 14,9 t/s. Maar zelfs de in totaal 128 GB geheugen van de Arcs is er niet genoeg om de model-layers en de KV-cache van al berekende tokens tegelijk in het geheugen te houden.
De GPU-offload haalt daarbij in het beste geval 88 van de 96 lagen, en zelfs dan raakt het geheugen al zo vol dat het ten koste gaat van de prestaties. Bij de test gaf 84 van de 96 lagen op de GPU het beste resultaat.
Linux-workstation
Voor verdere tests zijn we overgestapt op Linux, om precies te zijn op Ubuntu 24.04. Intel biedt daar namelijk vooraf geconfigureerde installatiescripts voor, tot en met complete Docker-containers voor vLLM en ook voor ComfyUI.
De containerinstallatie kon echter pas van start gaan nadat we Ubuntu überhaupt helemaal geïnstalleerd hadden. Want 24.04 LTS en 25.04, en ook de huidige versie 26.04 LTS hadden blijkbaar de juiste firmware-blobs voor de Arc B70-GPU’s niet. Dat dachten we in eerste instantie tenminste. Maar in werkelijkheid hadden we ons 4K-scherm juist aangesloten op die ene DisplayPort-poort die, in plaats van UHBR10, de hogere bitsnelheid van de UHBR13.5-specificatie bood. En juist die werkte niet onder Linux. Bij een latere poging op alle drie de overige DP-uitgangen verliep de installatie van 26.04 LTS zonder problemen.
Helaas wilde onze Ubuntu-desktop na afronding van de eerste installatie met BMC-uitvoer de grafische interface per se via de Arc-GPU weergeven, waardoor we eerst voor een zwart scherm zaten, want zelfs het beheer op afstand via BMC werkte niet.
Om het voorbereide Intel-pakket te kunnen installeren, moesten we de vier grafische kaarten verwijderen, vervolgens de software installeren, afsluiten, de grafische kaarten weer terugplaatsen en opnieuw opstarten.
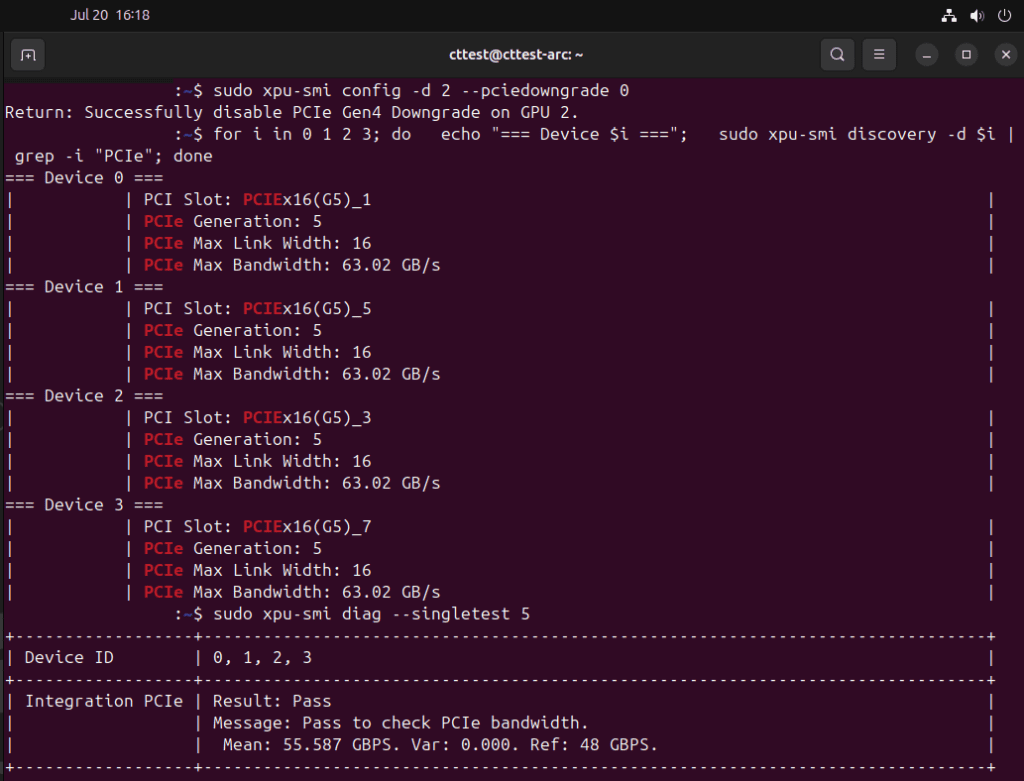
Met xpu-smi hebben we eerst de apparaatconfiguratie uitgelezen en ook daar zat een van de Arc-kaarten alleen in de PCIe-4.0-modus. Onder Linux kon dat, in tegenstelling tot onder Windows, echter worden opgelost met sudo xpu-smi config -d 2 –pciedowngrade 0 – waarbij -d 2 het betreffende apparaat aangaf.
We hebben verschillende LLM’s getest binnen de vLLM-container. Van het eenvoudige Llama-3.1-8B, dat al draaide met slechts één Arc Pro B70, tot GPT-OSS-120B, waarvoor we alle vier de grafische kaarten moesten inzetten om genoeg geheugen te hebben voor het model en de KV-cache. Drie zou rekenkundig gezien ook genoeg zijn geweest, maar de optie tensor-parallel-size voor de verdeling over meerdere kaarten accepteerde alleen gehele delers van 32, dus waren we beperkt tot 1, 2 of 4 kaarten.
Voordat we naar de resultaten gaan, nog even iets over de vergelijkbaarheid: de waarden onder Windows hebben we als individuele gebruiker met één enkel verzoek vastgesteld. Onder Linux hebben we het viertal als AI-server gebruikt en daarvoor een groot aantal gelijktijdige verzoeken gesimuleerd. Daarbij hebben we de kaarten ook volledig belast en bereikten of overschreden we de Thermal Design Power van 230 watt per kaart. De resultaten zijn zelfs bij dezelfde LLM’s niet vergelijkbaar met die onder Windows.
Met Llama-3.1-8B haalde het systeem op één kaart een totale doorvoer van 846 tokens/s, dus de som van meerdere verzoek- en antwoordtokens. Ook dat is een verschil met de Windows-tests, waarbij we de voor individuele gebruikers relevante antwoordtokens vermelden. Op twee kaarten was dat 1450 t/s en op alle vier 2033 t/s.
De grotere modellen Qwen3-30B-A3B en GPT-OSS-120B haalden op vier kaarten ook net iets meer dan 2000 outputtokens per seconde.
Wat alle modellen echter gemeen hadden, was dat de maximale doorvoer alleen haalbaar was met een groter aantal prompttokens (num-prompts). Korte verzoeken vervelen het systeem nogal, maar verzoeken in het midden van het drie- tot lage viercijferige bereik halen het maximale uit de hardware.
Bij de test stegen de tijden tot het begin van het antwoord (Time to first Token) boven een waarde van 200 voor de num-prompts echter steiler dan lineair.
Naarmate de vier grafische kaarten zwaarder werden belast, nam ook het energieverbruik toe. Terwijl dat onder Windows met een opgesplitst LLM bij afzonderlijke verzoeken nog rond de 70 watt per kaart lag, steeg de waarde tot (en boven) de Thermal Design Power wanneer alle vier de kaarten samen worstelden met veel GPT-OSS-120B-verzoeken.
Conclusie
Het Intel-systeem met vier Arc Pro B70-grafische kaarten deed, na een succesvolle installatie, precies waarvoor het bedoeld was. Potentiële kopers moeten zich er echter wel van bewust zijn dat afzonderlijke gebruikersverzoeken het systeem te weinig belasten. Er is al een kleine creatieve groep of een afdeling van een bedrijf nodig, om de hardware voldoende uit te dagen. Dan scoort een Intel-GPU-kwartet met zijn relatief lage prijs van zo’n 1250 euro per Arc Pro B70 en de goede geheugenconfiguratie zeker punten.
Maar laat je niet misleiden door die prijs per kaart: de totale kosten van de onderdelen lopen al snel op tot een vijfcijferig bedrag, zelfs voor een kleine AI-server.
Carsten Spille en Noud van Kruysbergen
Literatuur
[1] Carsten Spille en Noud van Kruysbergen, AI- en workstationkaart Asrock Arc Pro B70 Creator, c’t 10/2026, p.66
Links bij dit artikel
Intel Xeon w5-3435X

Praat mee