Lokaal AI draaien op een workstation: wat kan er praktisch al?
In samenwerking met onze partner Lenovo
Voor veel mensen is AI synoniem geworden met een chatvenster in de browser, met daarachter het datacenter van een grote aanbieder. Dat hoeft niet. Open-weight modellen als gpt-oss, Llama, Qwen en Mistral draaien tegenwoordig op een workstation onder je bureau of op een mobiel workstation in je tas, zonder dat een vraag of document je pand verlaat. Maar wat kun je daar in de praktijk mee, en waar houdt het op?
Lees verder na de advertentie
In dit artikel leggen we eerst uit wat lokaal AI draaien inhoudt en welke toepassingen nu al goed werken. Daarna kijken we naar de hardware: wat je nodig hebt, welke rol GPU, CPU en geheugen spelen en welke ThinkStation of ThinkPad P-configuratie bij welk model past. Tot slot komen privacy, prestaties en beperkingen aan bod, en de vraag hoe je van één workstation doorgroeit naar een schaalbare AI-werkomgeving.
Meer over deze onderwerpen lees je in ons e-book Wie beheert jouw AI?, dat we in samenwerking met Lenovo hebben gemaakt.
Wat is lokaal AI draaien?
Lokaal AI draaien betekent dat een model op je eigen apparaat wordt uitgevoerd in plaats van op de servers van een clouddienst. Je prompt, je documenten en het antwoord blijven op de machine. Technisch gaat het vrijwel altijd om inferencing: het gebruiken van een getraind model, niet het trainen ervan. Dat onderscheid is belangrijk, want inferencing vraagt veel minder rekenkracht dan training en past daarom wel op een workstation. Hoe de verschillende workloads zich tot server en cloud verhouden, lees je in het e-book.
Lokaal is niet hetzelfde als offline, en betekent ook niet een enkele oplossing voor de hele organisatie. Een model op één workstation bedient één persoon of een klein team. Willen meerdere collega’s via een webinterface met hetzelfde model werken, dan begin je aan een kleine eigen AI-server. Wat private AI daarbij betekent, lees je in het e-book.
Welke AI-toepassingen draaien al lokaal?
Het bekendste voorbeeld is een eigen chatassistent. Je downloadt een model via een programma als Ollama, zet er een interface als Open WebUI voor en je kunt teksten schrijven, samenvatten, vertalen en analyseren zonder dat die tekst een externe dienst bereikt.
Voor organisaties is RAG (retrieval-augmented generation) vaak interessanter. Het model doorzoekt dan je eigen documenten, zoals handleidingen, contracten of projectdossiers, en baseert zijn antwoord daarop. Dat werkt alleen als die bronnen op orde zijn; hoe je daarmee begint, staat in het e-book. Ook codeassistenten werken goed lokaal: een ontwikkelaar laat een model broncode uitleggen, reviewen of tests schrijven zonder dat die code ergens naartoe gaat. Daarnaast draaien spraak-naar-tekst, vertaling en het doorzoekbaar maken van grote documentverzamelingen prima op een workstation.
Dat de modellen daarvoor lokaal kunnen draaien is nieuw. Volgens OpenAI heeft gpt-oss-20b ongeveer 16 GB geheugen nodig en draait gpt-oss-120b op één GPU met 80 GB. Modellen van die omvang waren een paar jaar geleden nog voorbehouden aan datacenters. Daarnaast bestaan families als Llama, Qwen, Mistral en Gemma in allerlei formaten, van klein genoeg voor een laptop tot groot genoeg voor een serieuze workstation.
Welke hardware heb je nodig?
De vraag is niet welk workstation je koopt, maar welk model je wilt draaien en voor hoeveel mensen. Het model moet in het geheugen passen, en dat bepaalt de keuze. Grofweg zijn er drie niveaus, die Lenovo alle drie in de Nederlandse catalogus heeft.
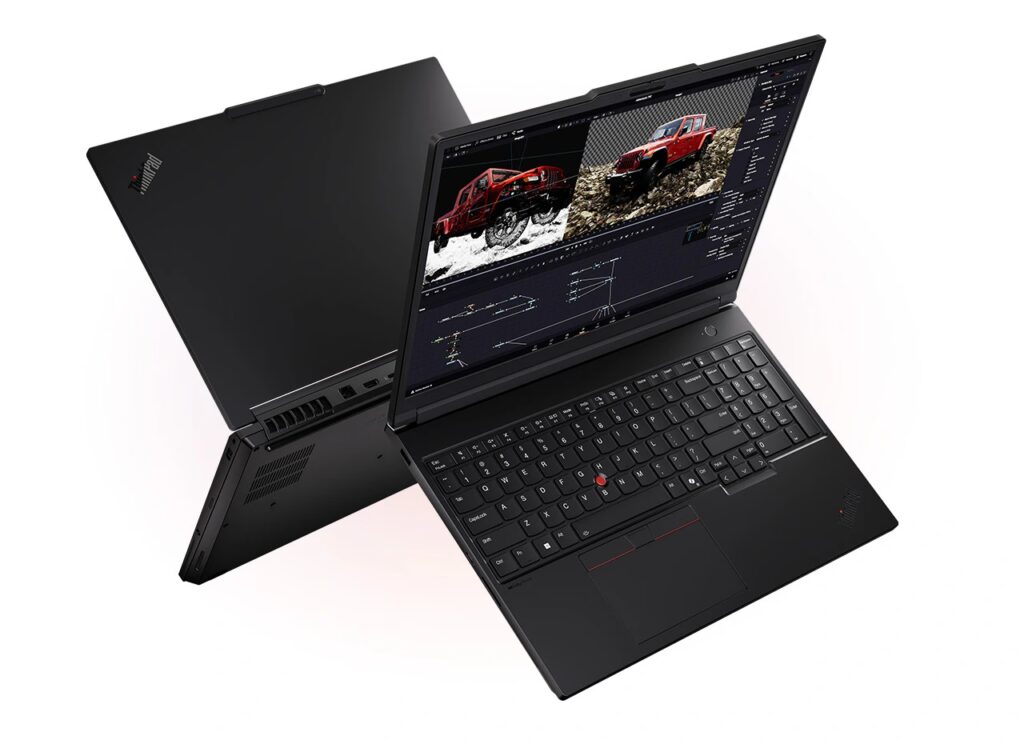
Het eerste niveau is een mobiel workstation uit de ThinkPad P-serie. De ThinkPad P16 Gen 3 is te configureren met NVIDIA RTX PRO Blackwell-laptop-GPU’s, van de RTX PRO 1000 met 8 GB tot de RTX PRO 5000 met 24 GB GDDR7. Daarmee draai je kleine en middelgrote modellen, zoals een gequantiseerd model van rond de 20 miljard parameters. Dat is handig voor een analist of ontwikkelaar die ook onderweg of bij een klant met gevoelige data wil werken.
Het tweede niveau is een ThinkStation-tower. De ThinkStation P3 Tower Gen 2 ondersteunt volgens Lenovo één NVIDIA RTX PRO 6000 Blackwell Workstation Edition. Die kaart heeft 96 GB geheugen, meer dan de 80 GB die gpt-oss-120b volgens OpenAI nodig heeft. Wie meer GPU’s en meer geheugen wil, kijkt naar de ThinkStation P5, P7 en PX, die in het het e-book aan bod komen.
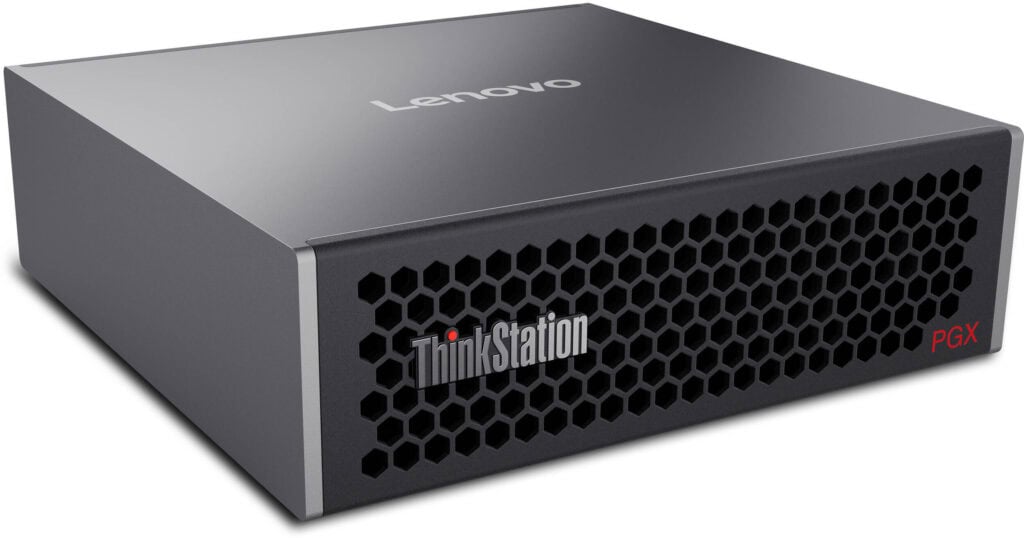
Het derde niveau is de ThinkStation PGX, een compact systeem op basis van de NVIDIA GB10 Grace Blackwell Superchip met 128 GB gedeeld geheugen. Dit apparaat moet modellen tot 200 miljard parameters aan kunnen, en tot 405 miljard als je twee systemen koppelt. Het draait NVIDIA DGX OS met de AI-softwarestack al geïnstalleerd. Met Open WebUI kun je er ook op afstand mee werken, zoals het artikel over Private AI laat zien.
De rol van GPU, CPU en geheugen
De GPU doet het rekenwerk, maar de belangrijkste specificatie is niet het aantal rekenkernen. Dat is het geheugen van de GPU, het VRAM. Het model moet daar helemaal in passen. Hoe groter het model en hoe minder het is ingekrompen (gequantiseerd), hoe meer geheugen het kost; in het artikel over server, workstation en cloud staat als vuistregel dat een model van 70 miljard parameters bij 16-bits precisie ruwweg 140 GB inneemt. Daar komt de context bij. Hoe langer het gesprek en hoe meer documenten je meegeeft, hoe meer geheugen er extra nodig is. Plan dus altijd marge.
Naast capaciteit telt de snelheid van dat geheugen. Het geheugen van een GPU met GDDR7 of GDDR6X is met meer dan 1000 GB/s veel sneller dan het DDR4 of DDR5 in een gewone pc of laptop, dat op 20 tot 100 GB/s uitkomt. Dat verschil bepaalt hoe snel een model tekst genereert. Past een model niet helemaal in het VRAM, dan verplaatst software als Ollama een deel van de lagen naar het systeemgeheugen en de CPU. Dat werkt, maar merkbaar trager.
De CPU zorgt voor al het andere: het laden van data, het indexeren van documenten en het besturingssysteem. Voor kleine modellen of eenvoudige taken kan hij het werk zelfs alleen af. Een NPU, zoals in een AI-laptop, is bedoeld voor lichte taken op het apparaat en geen vervanging van een GPU voor grote taalmodellen. Reken verder op een snelle NVMe-SSD met voldoende capaciteit, want modelbestanden beslaan al snel tientallen gigabytes, en op voldoende systeemgeheugen. Bij de ThinkStation PGX delen CPU en GPU hetzelfde geheugen, waardoor grotere modellen passen dan op een kaart met losse VRAM.
Privacy en dataveiligheid
Het sterkste argument voor lokaal AI is dat gegevens het apparaat niet verlaten. Contracten, klantdossiers en broncode gaan niet naar een externe dienst, en er zijn minder partijen betrokken bij de verwerking. Dat maakt het makkelijker om af te dwingen wat wel en niet mag. De AVG blijft echter gewoon gelden, ook als het model op je eigen machine draait.
Lokaal is ook niet vanzelf veilig. Een workstation met een niet-versleutelde schijf, gedeelde accounts of een map vol ongeclassificeerde documenten blijft een risico. Leg daarom vast wat er lokaal mag staan: modelbestanden, documentindexen en chatgeschiedenis horen bij het beleid. Dat geldt extra voor mobiele workstations, die kwijt kunnen raken. Op hardwareniveau helpt Lenovo ThinkShield met onder meer firmwarebescherming en een hardware root of trust. Keur ook de modellen zelf goed. Open-weight modellen komen met een licentie en een herkomst, en wie zomaar iets downloadt, wil dat achteraf kunnen uitleggen.
Prestaties en beperkingen van lokale AI
Lokaal AI vervangt de grootste cloudmodellen niet. De modellen die op een workstation draaien zijn kleiner en doen het minder goed bij complexe redeneertaken of zeer lange teksten. Ze zijn wel degelijk nuttig, maar je moet weten waar je ze voor inzet.
Daarnaast spelen een paar praktische grenzen. De snelheid, uitgedrukt in tokens per seconde, loopt terug bij grotere modellen en lange context. Een workstation bedient een persoon of een klein team; honderd gebruikers tegelijk vragen om een server. Er is geen redundante voeding, dus een bedrijfskritische toepassing hoort niet op één workstation te draaien. En beheer, zoals modelversies, updates en monitoring, komt bij jou te liggen.
De beste manier om dit te ontdekken is testen met je eigen use case en je eigen documenten, met een nulmeting vooraf. Een model dat goed scoort op een benchmark kan bij jouw teksten tegenvallen, en andersom.
Van workstation naar schaalbare AI-werkomgeving
Een workstation is een goed startpunt, juist omdat je klein begint. Je valideert een idee, meet het resultaat en investeert pas daarna in meer. Lenovo positioneert de ThinkStation PGX als platform voor het prototypen van modellen en toepassingen, zodat de rekenkracht in clusters of de cloud beschikbaar blijft voor training en productie.
Het groeipad ziet er in de praktijk zo uit. Een ontwikkelaar begint op een mobiel workstation of een ThinkStation. Werkt het, dan krijgt een team toegang via een gedeelde machine met Open WebUI. Neemt het gebruik toe, dan verhuist de toepassing naar ThinkSystem-servers in het datacenter of naar een hybride opzet. Omdat tools als Ollama en Open WebUI open zijn, blijft zo’n verhuizing overzichtelijk, zeker als je vanaf het begin modulair kiest.
Ook de financiering kan meegroeien. Met Lenovo TruScale neem je infrastructuur als dienst af en betaal je naar gebruik. En wie zo’n traject niet alleen wil uitzetten, vindt in het e-book hoe een adviseur dat samen met een klant aanpakt. Zo wordt de eerste lokale toepassing de basis voor de volgende.
Meer weten?
In ons e-book Wie beheert jouw AI?, gemaakt in samenwerking met Lenovo, lees je hoe je AI veilig en effectief binnen je organisatie kunt inzetten, zonder de controle over gevoelige bedrijfsgegevens te verliezen. Je ontdekt wat private AI inhoudt, hoe je van losse AI-experimenten naar een concrete bedrijfsstrategie komt en welke afwegingen een rol spelen bij de keuze tussen een workstation, eigen server of cloudomgeving. Ook krijg je inzicht in de hardwarevereisten voor lokale AI, de mogelijkheden van open AI-modellen en hoe je een AI-infrastructuur opbouwt die kan meegroeien met je organisatie.
Vul het formulier hieronder in om het gratis e-book te downloaden.

Praat mee