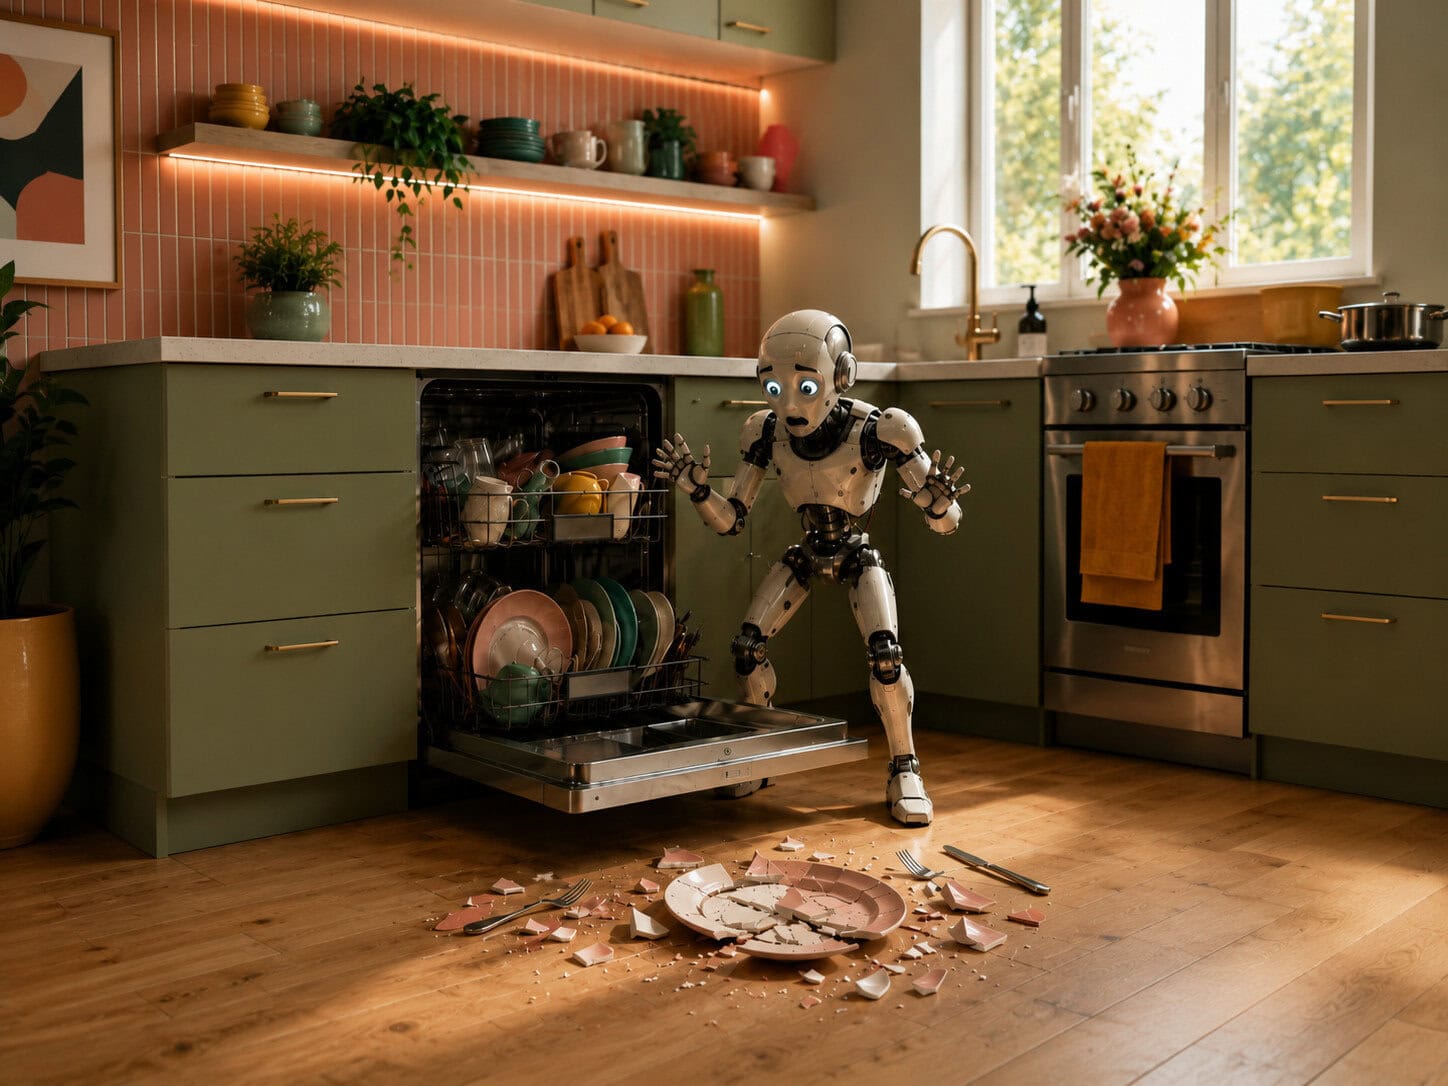

Ze dansen, springen en pakken dingen vast, maar snappen eigenlijk nauwelijks wat er om hen heen gebeurt. Humanoïde robots maken indruk met ingestudeerde bewegingen, maar ze vinden het moeilijk om zelfstandig te handelen. Om daar verandering in te brengen, zou open onderzoek wel eens belangrijker kunnen zijn dan de miljardenbudgetten van bepaalde bedrijven.
Iedereen een robot in huis
De visie is duidelijk: een humanoïde robot in elk huis, wereldwijd. Gedreven door het vooruitzicht op grote winsten strijden vooral Chinese en Amerikaanse bedrijven om de leiding in de race om de eerste kunstmatige huishoudhulp. Maar veel van wat ze in hun reclamefilmpjes laten zien, is misleiding en schijn.
Een Unitree G1 die met spectaculaire vechtsportbewegingen door een hal wervelt maakt misschien indruk, maar nuttig is hij daarom nog niet. Hij wordt gemaakt en ontwikkeld door het Chinese robotica-bedrijf Unitree Robotics.
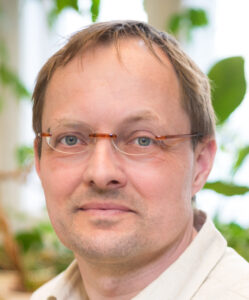
De systeemintegrator Unchained Robotics uit Paderborn helpt klanten uit Europa bij de aanschaf, inbedrijfstelling en integratie. En als een Figure 03 van het Amerikaanse bedrijf Figure AI de vaatwasser inruimt, kun je je afvragen of hij dat bij elk willekeurig apparaat ook zo mooi voor elkaar krijgt, of dat hij misschien toch alleen met veel moeite speciaal voor precies deze ene scène is voorbereid.
“Die kungfu-bewegingen zijn allemaal ‘aangeleerd’, dus voorgedaan en vervolgens geleerd”, zegt professor Markus Vincze. “Ze zijn niet ontstaan als reactie op een interactie met de omgeving, behalve dan dat de robot ervan uitgaat dat de vloer vlak is.” Vincze leidt het lab Vision for Robotics aan de TU Wenen en ontwikkelt software voor robots die in huishoudelijke situaties van nut moeten zijn.
Hij kent de problemen waar robots in de echte wereld tegenaan lopen maar al te goed, en ingestudeerde bewegingen helpen daar maar beperkt. De machines moeten juist hun omgeving begrijpen en leren ermee om te gaan. “Als een robot in zo’n filmpje een vaatwasser inruimt, zijn dat misschien drie borden met veel ruimte ertussen“, zegt de onderzoeker. „Maar als je hem iets kleins laat pakken, zoals een gummetje, dat meestal al niet meer.”
De robots missen krachtige Physical AI. Die term verwijst naar AI-systemen die niet alleen informatie verwerken, maar ook in de echte wereld handelen. Ze combineren waarneming, begrip, planning en beweging, zodat robots kunnen omgaan met mensen, voorwerpen en hun omgeving.
Slim opruimen
Toch mogen de huidige vorderingen in de robotica zeker niet worden onderschat. Nog maar een paar jaar geleden zagen bijvoorbeeld robotstofzuigers de wereld om zich heen alleen als een puntenwolk van sensorgegevens, zonder meubels zoals tafels of stoelen als zodanig te herkennen, laat staan dat ze überhaupt iets konden beginnen met het idee van een tafel.
“Taalmodellen hebben inmiddels veel dingen makkelijker gemaakt”, zegt Vincze. “De context die voor een mens volkomen vanzelfsprekend is, bijvoorbeeld wat het betekent om een tafel af te ruimen, kan met deze systemen nu heel goed worden weergegeven.” Bovendien zijn taalsystemen ook in staat om plannen te ontwikkelen die programmeurs voorheen moeizaam stap voor stap zelf moesten opstellen.
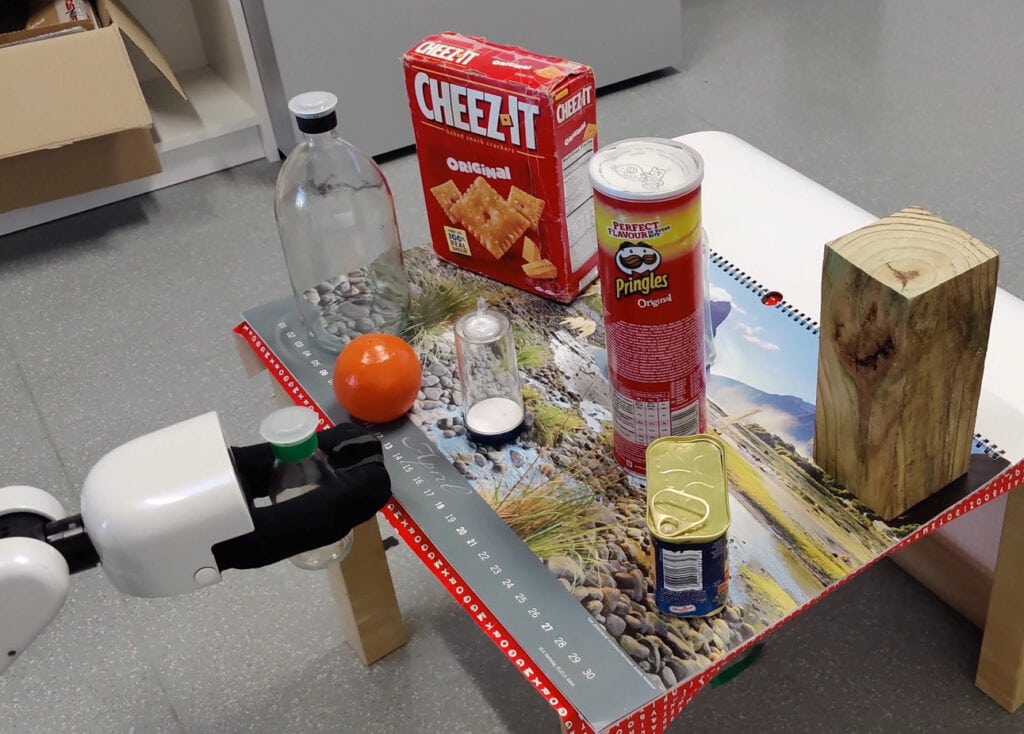
In zijn onderzoek richt Vincze zich vooral op de visuele waarneming van robots. In een project met zijn studenten heeft hij bijvoorbeeld een Toyota HSR (Human Support Robot) geleerd om zich in een rommelig huishouden nuttig te maken en op te ruimen. Daarvoor hebben ze de robot, die maar één grijparm heeft, met behulp van het Vision-Language-model LLaMA 3.2 Vision zover gekregen dat hij natuurlijke spraakopdrachten begrijpt en daar concrete acties uit afleidt.
Vision-Language-modellen (VLM) combineren beeldverwerking en taalbegrip. Ze stellen een robot in staat om zijn omgeving niet alleen te zien, maar ook taalkundig te interpreteren. “Het systeem maakt automatisch een plan van welke afzonderlijke stappen nodig zijn om bijvoorbeeld een tafel af te ruimen”, legt Vincze uit. “Dus dat je bijvoorbeeld eerst de spullen pakt die vooraan staan, en dan meteen ook beslist waar je ze weer neerzet.”
VLM’s geven echter alleen aan welke handelingen de machine in welke volgorde moet uitvoeren. Hoe precies hij daarbij moet bewegen, kunnen ze nog niet voorschrijven.
Ruimtelijk zicht voor robots
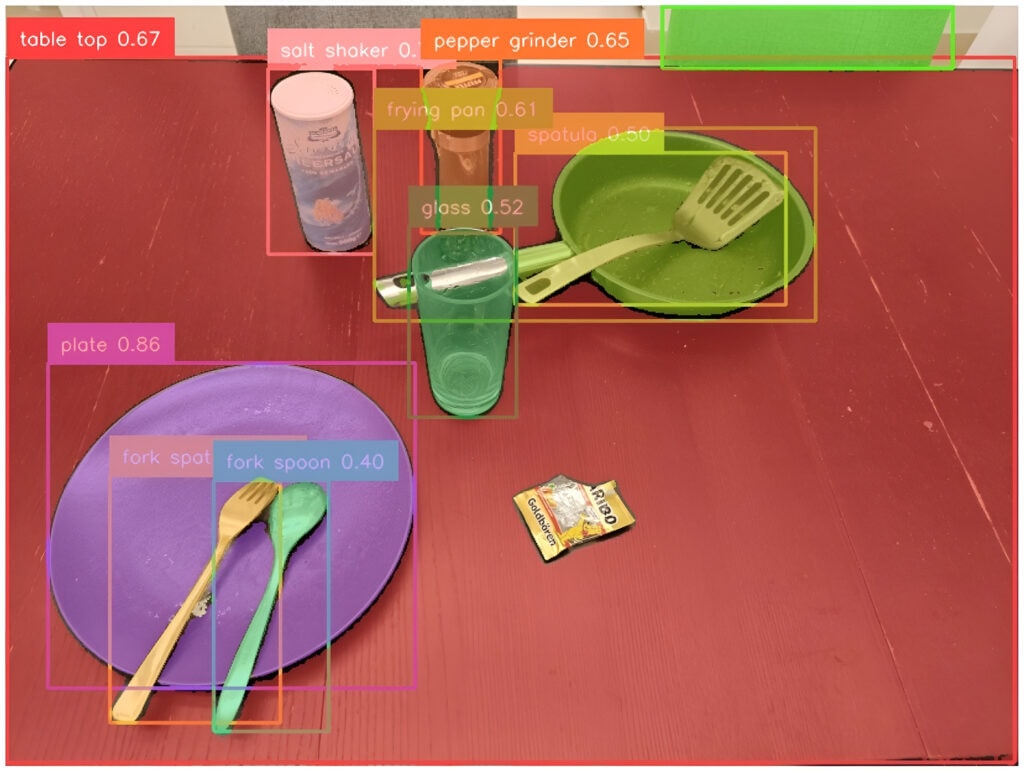
Vinczes expertise komt goed van pas bij het bepalen van de ruimtelijke positie van een object aan de hand van de beelden van de robotcamera. Zijn team gebruikt verschillende gratis beschikbare modellen, zoals Nvidia’s FoundationPose, dat de positie van een object in de ruimte bepaalt. Het is getraind met alledaagse voorwerpen zoals flessen, mueslipakken of accuschroevendraaiers, maar past zijn vaardigheden ook toe op andere, vergelijkbare voorwerpen (generalisatie).
FoundationPose bepaalt de ruimtelijke positie door een bekend 3D-model te vergelijken met het camerabeeld van de robot. Hiervoor genereert het mogelijke posities en oriëntaties van het object en projecteert deze in het beeld. De variant die het beste past, wordt stap voor stap verfijnd, totdat uiteindelijk de exacte positie en oriëntatie van het object zijn gevonden.
Open(source)
Het opensource-platform MoveIt voor het aansturen van robotarmen berekent vervolgens de route voor de grijparm van de Toyota HSR. Het werkt met klassieke planningsalgoritmen. Bij grote robotfabrikanten worden vaak al puur datagestuurde AI-benaderingen gebruikt, die naast beelden en taal ook robotbewegingen in één model samenbrengen: de Vision-Language-Action-modellen (VLA).
“Daarvoor zijn ongelooflijke hoeveelheden data en hardwarebronnen nodig”, zegt Vincze. “Om daar iets tegenover te kunnen stellen, zouden we er in Europa goed aan doen om op opensource in te zetten.”
Omgangsvormen voor robots
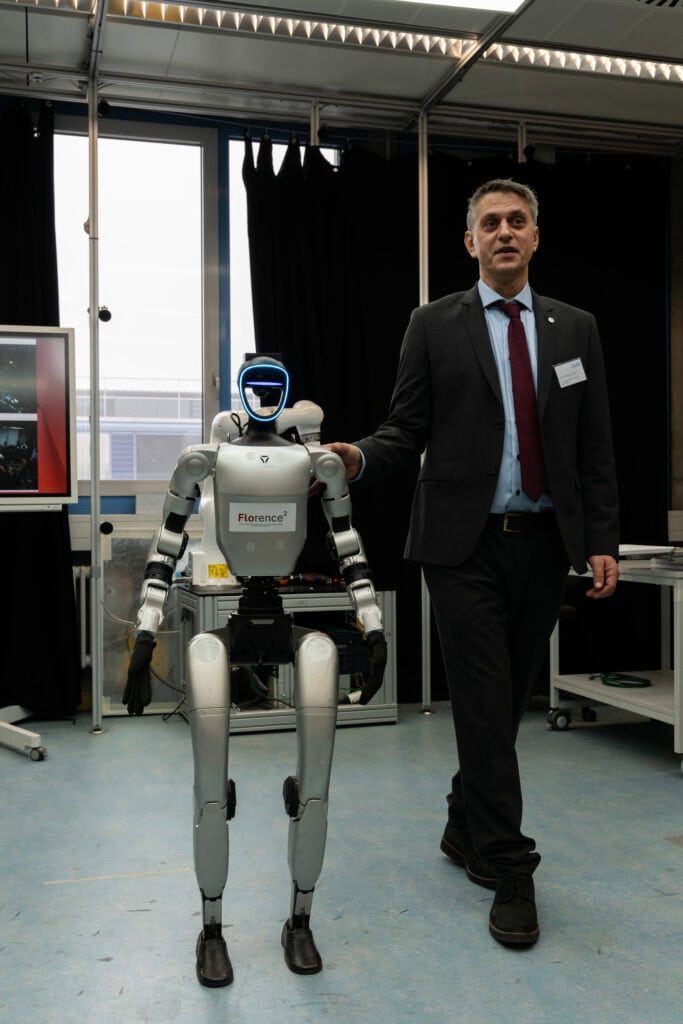
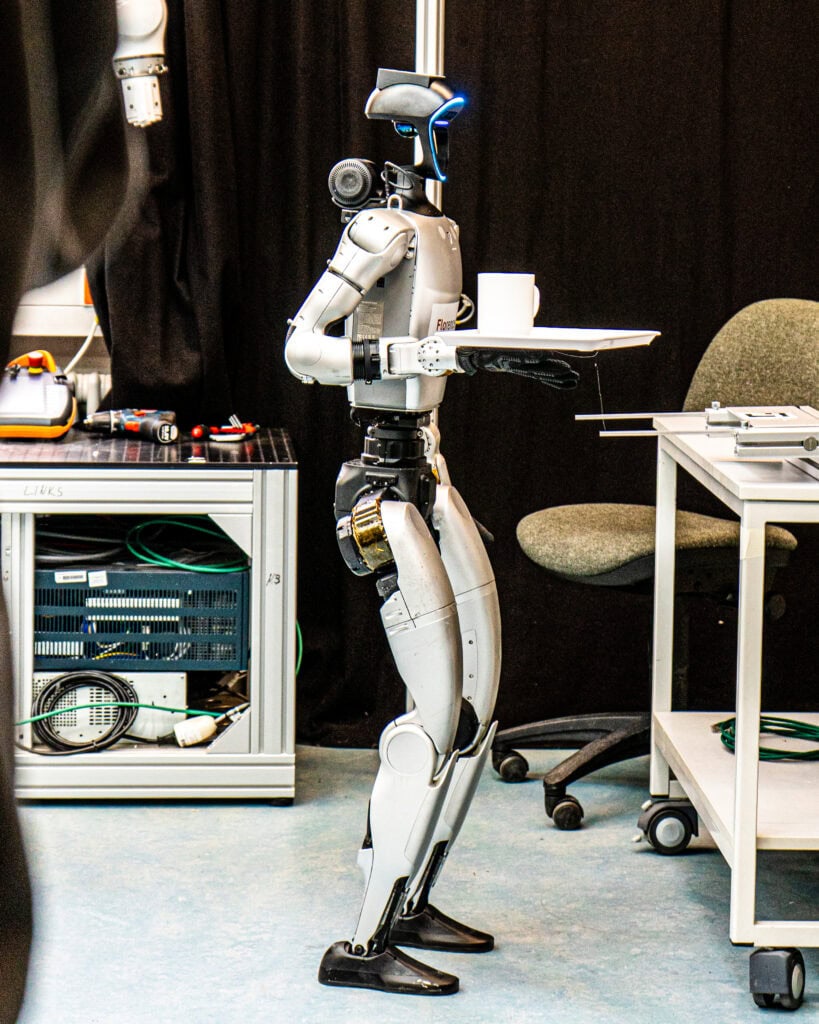
Bedrijven hebben zoveel mogelijk echte interactiegegevens nodig om algemeen inzetbare humanoïde robots te kunnen trainen. Het Chinese bedrijf Unitree heeft daarom gekozen voor een open systeem en stelt zijn G1 ter beschikking voor universitair onderzoek. “Strategisch gezien is het waarschijnlijk heel slim om zo’n goede technologie op deze manier in de onderzoeksgemeenschap te brengen”, zegt professor Marcus Vetter, die aan de Technische Hogeschool Mannheim het Institute for Applied Artificial Intelligence and Robotics leidt.
Dat versnelt niet alleen de ontwikkeling, maar kan ook helpen om het platform te vestigen als testomgeving voor moderne AI-methoden en daarmee als standaard voor VLA-onderzoek. De onderzoeksvariant G1 EDU U4, waarmee Vetter en zijn collega’s in Mannheim experimenteren, beschikt over programmeerinterfaces waarmee onderzoekers op allerlei niveaus met de robot kunnen communiceren, tot op het niveau van afzonderlijke sensoren en actuatoren.
“Nu al kan een G1 zich op basis van zijn sensorgegevens in gebouwen oriënteren en veilig langs tafels en stoelen navigeren”, zegt Vetter. “En ook de mechanica is al zo ver ontwikkeld dat hij daarmee basis taken in het huishouden zou kunnen uitvoeren.” De robot mist echter het vermogen om met mensen om te gaan.
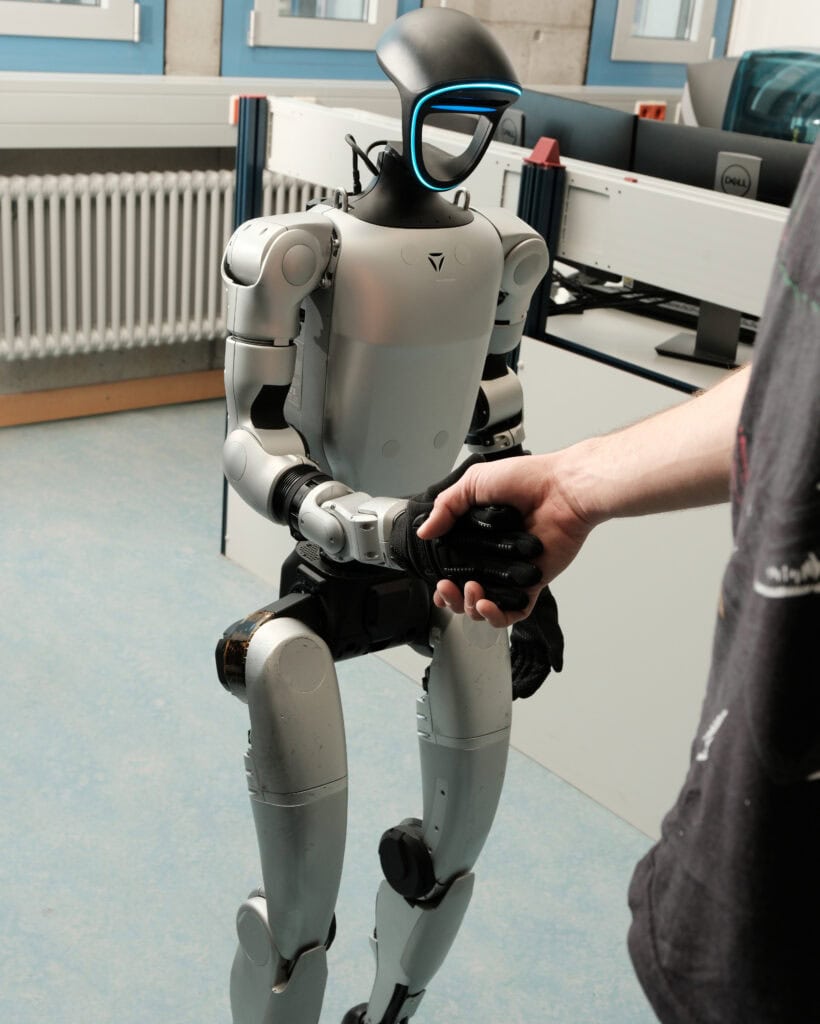
Je kunt hem bijvoorbeeld wel opdragen zijn hand uit te steken om iemand te begroeten. Maar of iemand die hand dan ook echt wil aannemen en schudden, kan hij niet inschatten. Hij is niet in staat om sociale situaties te doorgronden, noch om daar gepast op te reageren.
Om hem dat bij te brengen, leren Vetter en zijn team hem de lichaamstaal van mensen te herkennen en daaruit hun bedoelingen af te leiden: bijvoorbeeld of iemand überhaupt contact wil of juist liever wat meer afstand houdt. “Op dit moment werken we aan het direct overhandigen van voorwerpen”, zegt Vetter. “Daarbij willen we een interactie tot stand brengen die zowel sociaal als fysiek zinvol is.”
Om de benodigde trainingsgegevens hiervoor te genereren, observeren de onderzoekers in hun lab eerst hoe mensen met elkaar omgaan. Meerdere camera’s leggen dit vanuit verschillende perspectieven vast. Zo ontstaat een zo volledig mogelijk beeld van hoe mensen zich ten opzichte van elkaar positioneren bij het overhandigen van een voorwerp en hoe ze op sociaal vlak reageren.
In de volgende stap wordt het experiment herhaald, maar deze keer is het de robot die het voorwerp overhandigt. Zo kun je de verschillen in de reacties van mensen zichtbaar maken. De onderzoekers voeren de verzamelde gegevens vervolgens in simulatietools zoals Isaac Sim van Nvidia in. Daar kunnen ze verschillende varianten van de interactie genereren en doorlopen om het gedrag van de robot systematisch te optimaliseren.
Isaac Sim maakt deel uit van Nvidia’s visie op een Physical AI die in de echte wereld handelt. Als een soort veilige, virtuele speelplaats voor robots bootst de simulatieomgeving bewegingen, botsingen en wrijvingseffecten fysisch correct na. “Voor de G1 levert Nvidia zelfs componenten mee”, zegt Vetter. “De robot zit dus al als fysisch model, met alle krachten en koppels, in de simulatieomgeving.”
Digitale empathie
Centraal in Vetters onderzoek staat de visie om robots een gevoel te geven voor de sociale situatie waarin ze zich bevinden. In plaats van alle verkregen inzichten meteen in één groot VLA-model te integreren, combineren hij en zijn collega’s vaak kleinere, gespecialiseerde AI-modellen. Die beoordelen de situatie en geven hun resultaten vervolgens in de vorm van taal door aan het VLA-model.
Dat kunnen bijvoorbeeld aanwijzingen zijn als: “Let op, deze persoon wil nu iets van je” of “Je gesprekspartner lijkt nu een beetje bang.” “Omdat we nog maar net begonnen zijn met ons onderzoek, is het zinvol om deze instructies expliciet te houden en het gedrag van de robot op deze manier als het ware van buitenaf mee te sturen”, legt Vetter uit.
“Op de lange termijn zal men dit waarschijnlijk allemaal in één groot VLA-model samenvoegen.” Vetter acht het realistisch dat humanoïde robots op deze manier al binnen een paar jaar in staat zullen zijn om de eerste zinvolle taken in het huishouden uit te voeren. Volgens hem zullen ze dan al eenvoudige dienstverlenende taken uitvoeren, zoals drankjes brengen of afruimen, kwetsbare mensen helpen bij het opstaan of gewoon even in de woning kijken of alles in orde is.
Samen in plaats van ieder voor zich
Open, samenwerkende systemen zoals dat van Unitree zijn echter eerder de uitzondering. In plaats daarvan doen veel spelers onafhankelijk van elkaar achter gesloten deuren hun eigen ding. Zo boeken afzonderlijke onderzoeksgroepen weliswaar vooruitgang, maar die draagt vaak niet bij aan het algemene doel van de robotontwikkeling.
Het gevolg is dat de ontwikkeling van Vision-Language-Action-modellen over het algemeen nogal traag verloopt. “Het is niet genoeg om een goed leeralgoritme te hebben”, legt Wolfram Burgard uit, hoogleraar robotica en kunstmatige intelligentie aan de Technische Universiteit van Neurenberg. “Je hebt ook trainingsgegevens nodig en daarvoor moet je met de robots in de echte wereld of in simulaties experimenteren en wat ze hebben geleerd weer terugkoppelen naar het leerproces.”
Om dit proces efficiënter te maken en de benodigde hoeveelheid gegevens te genereren, hebben Burgard en zijn collega’s met VLAgents een aanpak ontwikkeld die een gemeenschappelijke infrastructuur voor VLA-systemen moet creëren.
Centraal staat daarbij een eenvoudig, maar effectief idee: in plaats van elk robotsysteem lokaal een eigen Vision-Language-Action-model te laten uitvoeren, wordt de beslissingslogica uitbesteed aan een grote, centrale server met een groot, centraal model.
De afzonderlijke robots sturen hun waarnemingen naar deze server en krijgen passende acties terug. Zo ontstaat uit veel afzonderlijke systemen een gezamenlijk netwerk dat toegang heeft tot één enkele, consistente AI.
“Uiteindelijk gaat het erom de beschikbare middelen effectief te gebruiken, dus zo efficiënt mogelijk van trainingsdata naar VLA-modellen te komen”, zegt Burgard. “En dat is in wezen een probleem van gegevensbeheer.” Als veel robots tegelijk werken, ontstaan er gegevens uit de meest uiteenlopende omgevingen, perspectieven en sensoromstandigheden. Juist die diversiteit zou met een systeem als VLAgents verzameld en benut kunnen worden. “We hopen dat er een ecosysteem ontstaat waarin we in de toekomst wereldwijd en met gestandaardiseerde software VLA-modellen kunnen trainen”, zegt Burgard.
Open robotplatforms, gedeelde infrastructuur en opensource-software zouden zo een belangrijk tegenwicht kunnen vormen tegen de propriëtaire systemen van grote bedrijven. De ontwikkeling van bruikbare humanoïde robots wordt immers geen olympische sprint die één bedrijf of één land in zijn eentje kan winnen.
Het is eerder een volksmarathon die breedte, diversiteit en doorzettingsvermogen vereist. Juist voor Europa zou een gezamenlijk ecosysteem, waarin universiteiten, onderzoeksinstituten en bedrijven de krachten bundelen, een kans zijn om de technische achterstand niet te laten oplopen.
Wolfram Burgard is er in ieder geval van overtuigd: “Een echt bruikbaar VLA-model zullen we niet op één enkele locatie kunnen ontwikkelen. Dat lukt geen enkele speler in zijn eentje.”
Thomas Brandstetter en Alieke van Sommeren
Links bij dit artikel
LLM-Empowered Embodied Agent for Memory-Augmented Task Planning in Household Robotics
https://arxiv.org/pdf/2504.21716
A Policy Server for Efficient VLA Inference
Nvidia FoundationPose
Praat mee